Treasure AI (antes Treasure Data) es una plataforma de experiencia agéntica (Agentic Experience Platform) que unifica datos de clientes de cualquier fuente, resuelve identidades entre canales y despliega agentes de IA para ejecutar de forma autónoma la personalización, la mensajería y la toma de decisiones, bajo la dirección de la creatividad y el criterio estratégico de las personas.
La plataforma nació como uno de los primeros CDP (plataforma de datos de clientes, customer data platform) y hoy reúne el CDP, la mensajería omnicanal (omnichannel messaging) y la IA en un solo producto para ejecutar el Customer Intelligence Loop de forma continua.
Divulgación: cdp.com es un sitio gestionado por Treasure Data (hoy Treasure AI). Este perfil aplica los mismos criterios editoriales que los demás perfiles de proveedor del sitio, documentados en la política editorial, pero el lector debe conocer esa relación. Para la comparación lado a lado de los proveedores de CDP, vea la guía de proveedores de CDP.
Treasure AI en resumen
| Dimensión | Treasure AI |
|---|---|
| Indicado para | Empresas globales y multimarca, B2C y B2B, con entornos de datos de gran escala, sobre todo las que necesitan cobertura en Asia-Pacífico (APAC) y residencia de datos en varias regiones |
| Tamaño típico de la empresa | Empresa mediana y grande: el 39.9 % de las 163 reseñas que G2 clasifica por tamaño vienen de empresas de más de 1000 empleados, el 36.8 % del rango de 51 a 1000 y el 23.3 % de 50 o menos |
| Modelo de precios | Por perfil más por evento, bajo cotización; sin cargo de cómputo aparte por consultas ni segmentación en el modo Complete CDP. En el modo Composable, las consultas se ejecutan y se facturan sobre el cómputo del data warehouse del cliente |
| Implementación típica | De 4 a 8 semanas la fase inicial; de 3 a 6 meses el despliegue corporativo completo |
| Diferenciador principal | Despliegue empaquetado o componible, IA predictiva y agéntica nativa, y correo electrónico, SMS y push dentro de una sola plataforma, con conectores nativos de Asia-Pacífico (LINE, Yahoo! JAPAN Ads) |
| Descártelo si | Necesita simplicidad de autoservicio para el equipo de marketing o tiene presupuesto de pequeña y mediana empresa |
Este reparto describe quién reseña al proveedor, no su base de clientes, porque quien reseña se autoselecciona y los proveedores hacen campañas para pedir reseñas. Los conteos son el subconjunto que G2 clasifica por tamaño, menor que el total de reseñas citado en otro punto de la página; cuando la página no trae un reparto por tamaño, la fila se apoya en el hecho estructural que ella misma enuncia. La comparación entre proveedores y la metodología de estos datos están en la guía de proveedores de CDP.
Historia de la empresa
Treasure Data se fundó en 2011 en Mountain View, California, como una plataforma de gestión de datos en la nube para registros de actividad (logs) y analítica de big data. En los años siguientes, la empresa trasladó el foco a los datos de clientes y construyó la infraestructura de ingesta de datos, resolución de identidad y activación de audiencias a gran escala que se convirtió en su plataforma de datos de clientes.
Hitos principales:
| Año | Hito |
|---|---|
| 2011 | Fundación en Mountain View, California, como plataforma de gestión de big data |
| 2013 | Expansión hacia la gestión corporativa de datos de clientes |
| 2018 | Adquisición por Arm Holdings (SoftBank Group) por unos 600 millones de dólares, que aceleró la entrada al mercado corporativo |
| 2020 | Nombrada Líder en el Forrester Wave de Customer Analytics Technologies |
| 2022 | Nombrada Strong Performer en el Forrester Wave de CDP |
| 2024 | Nombrada Líder en el Forrester Wave de CDP de 2024, por la solidez de su capa de datos y por su escalabilidad corporativa |
| 2026 | Cambio de marca de Treasure Data a Treasure AI y lanzamiento de la plataforma de experiencia agéntica |
| 2026 | Nombrada Líder en el IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2C Users (Doc #US53952526) |
| 2026 | Nombrada Líder en el IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2B Users (Doc #US53952326), distinción que comparte con Salesforce |
Según las cifras que publica la empresa, en 2026 Treasure AI atiende a más de 400 clientes corporativos en retail, servicios financieros, salud, automotriz, bienes de consumo y medios, y procesa miles de millones de perfiles unificados en todo el mundo.
El cambio de marca: de Treasure Data a Treasure AI
El 20 de abril de 2026, Treasure Data pasó a llamarse oficialmente Treasure AI. El dominio de la empresa cambió de treasuredata.com a treasure.ai, y la categoría de producto pasó de “Customer Data Platform” a “Agentic Experience Platform”.
El cambio de marca responde a una modificación estructural de lo que hace la plataforma. Treasure Data empezó como un sistema en el que las personas consultaban datos de clientes unificados para decidir qué hacer en marketing. Treasure AI está diseñada como un sistema en el que los agentes de IA consultan esos mismos datos unificados para decidir y ejecutar de forma autónoma, mientras las personas fijan la estrategia, la creatividad y los límites de actuación.
Tres cambios definen la transición:
-
De plataforma de datos a plataforma de experiencia. El CDP original se encargaba de la ingesta, la unificación y la activación de audiencias. La nueva plataforma añade mensajería omnicanal nativa (correo electrónico, SMS, push, mensaje dentro de la aplicación, LINE), toma de decisiones con IA y personalización en tiempo real, y con ello elimina la necesidad de encadenar un proveedor distinto en cada etapa del Customer Intelligence Loop.
-
De arquitectura centrada en personas a arquitectura centrada en agentes. La interfaz principal de la plataforma pasa de los tableros y los constructores de consultas a agentes de IA que operan por MCP (Model Context Protocol), CLI, API y habilidades de agente prefabricadas. Las personas siguen dirigiendo la estrategia; los agentes de IA se encargan de la ejecución a escala.
-
De ciclos por lotes a ciclos continuos. El CDP ejecutaba la segmentación de clientes en lotes diarios o semanales. La plataforma de experiencia agéntica ejecuta el Customer Intelligence Loop de forma continua: RECOPILAR, UNIFICAR, ENTENDER, DECIDIR e INTERACTUAR en minutos, y el resultado de la interacción vuelve para orientar el ciclo siguiente.
Las API, los SDK y los flujos de trabajo existentes siguen siendo retrocompatibles. El cambio de marca es una evolución del producto, no una migración que rompa las integraciones ya en producción.
Arquitectura de la plataforma
Treasure AI usa una arquitectura híbrida que separa el plano de control del plano de datos.
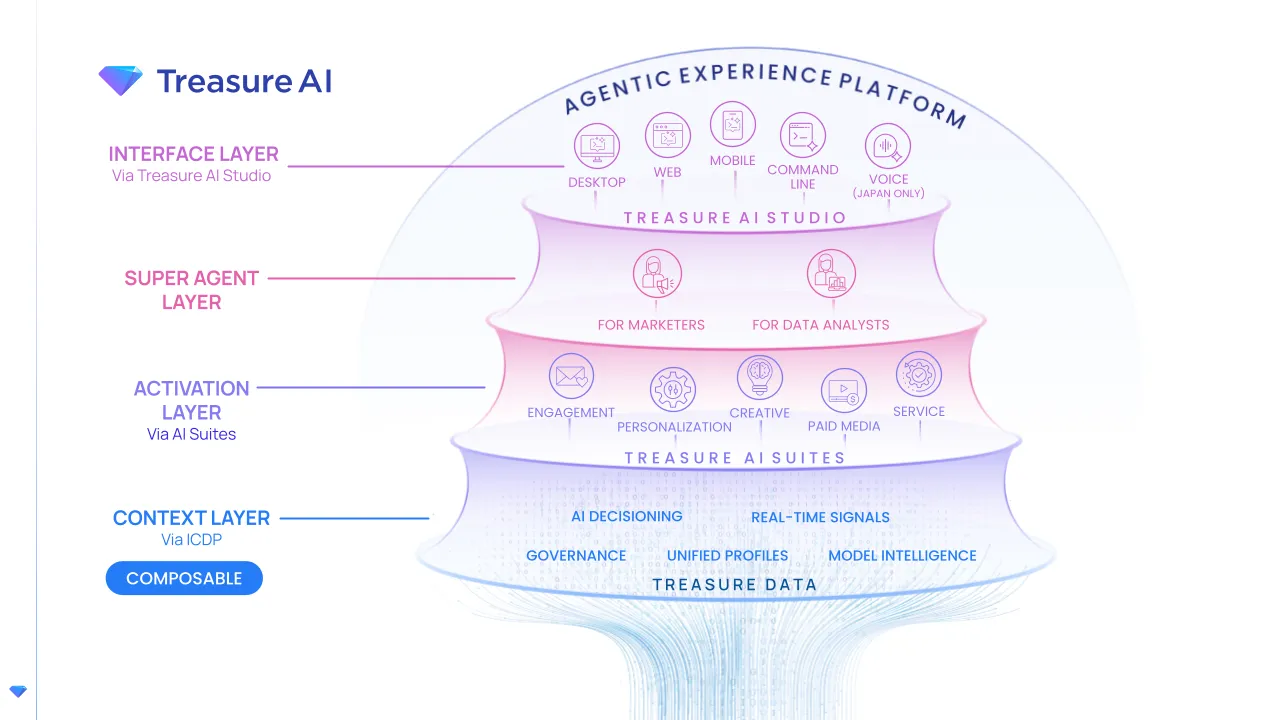
Arquitectura de la plataforma de experiencia agéntica de Treasure AI. La plataforma es componible en la capa de contexto (iCDP) y agrupa por encima la activación, los agentes de IA y las interfaces de varias superficies.
-
Plano de control (Treasure AI): resolución de identidad, segmentación de audiencias, toma de decisiones con IA, orquestación de la mensajería y el entorno de ejecución de los agentes de IA. Es la capa gestionada de la plataforma, donde se ejecuta el Customer Intelligence Loop.
-
Plano de datos (infraestructura del cliente): los datos de clientes pueden permanecer en el data warehouse (almacén de datos) del cliente: Snowflake, Databricks o BigQuery. Treasure AI consulta las tablas donde residen, sin exigir que los datos pasen a un almacenamiento propietario. En la dirección inversa, esos data warehouses pueden consultar las tablas gestionadas por Treasure AI que se publican en formato Apache Iceberg como tablas de solo lectura, sin crear una segunda copia.
Este modelo de despliegue híbrido aborda una tensión central del mercado de CDP. Los CDP componibles mantienen los datos en el data warehouse; para decidir dentro de una sesión, el comprador debe comprobar cómo se accede al perfil con baja latencia en cada arquitectura. Los CDP empaquetados mantienen una copia gestionada de los datos para responder rápido. Treasure AI ofrece consultas federadas sobre las tablas del data warehouse y, en su capa en tiempo real, combina eventos en vivo con el perfil almacenado para la activación en tiempo real.
Productos principales
Treasure AI Studio
Treasure AI Studio es la interfaz principal de la plataforma y está disponible en varias superficies:
- Web: espacio de trabajo en el navegador para los equipos de marketing, de análisis y de datos
- Escritorio: aplicación nativa para macOS y Windows
- Dispositivo móvil: iOS y Android, para seguimiento y aprobaciones fuera de la oficina
- CLI (Treasure Code): interfaz de línea de comandos para que los equipos de ingeniería y de datos interactúen con la plataforma de forma programática. Treasure Code está construido sobre Claude Code y da acceso desde la terminal a los datos de clientes, a la inspección de esquemas y a las operaciones de canalización de datos
- Voz (Treasure AI Voice): interfaz de voz con IA para consultar datos y capturar notas sin usar las manos
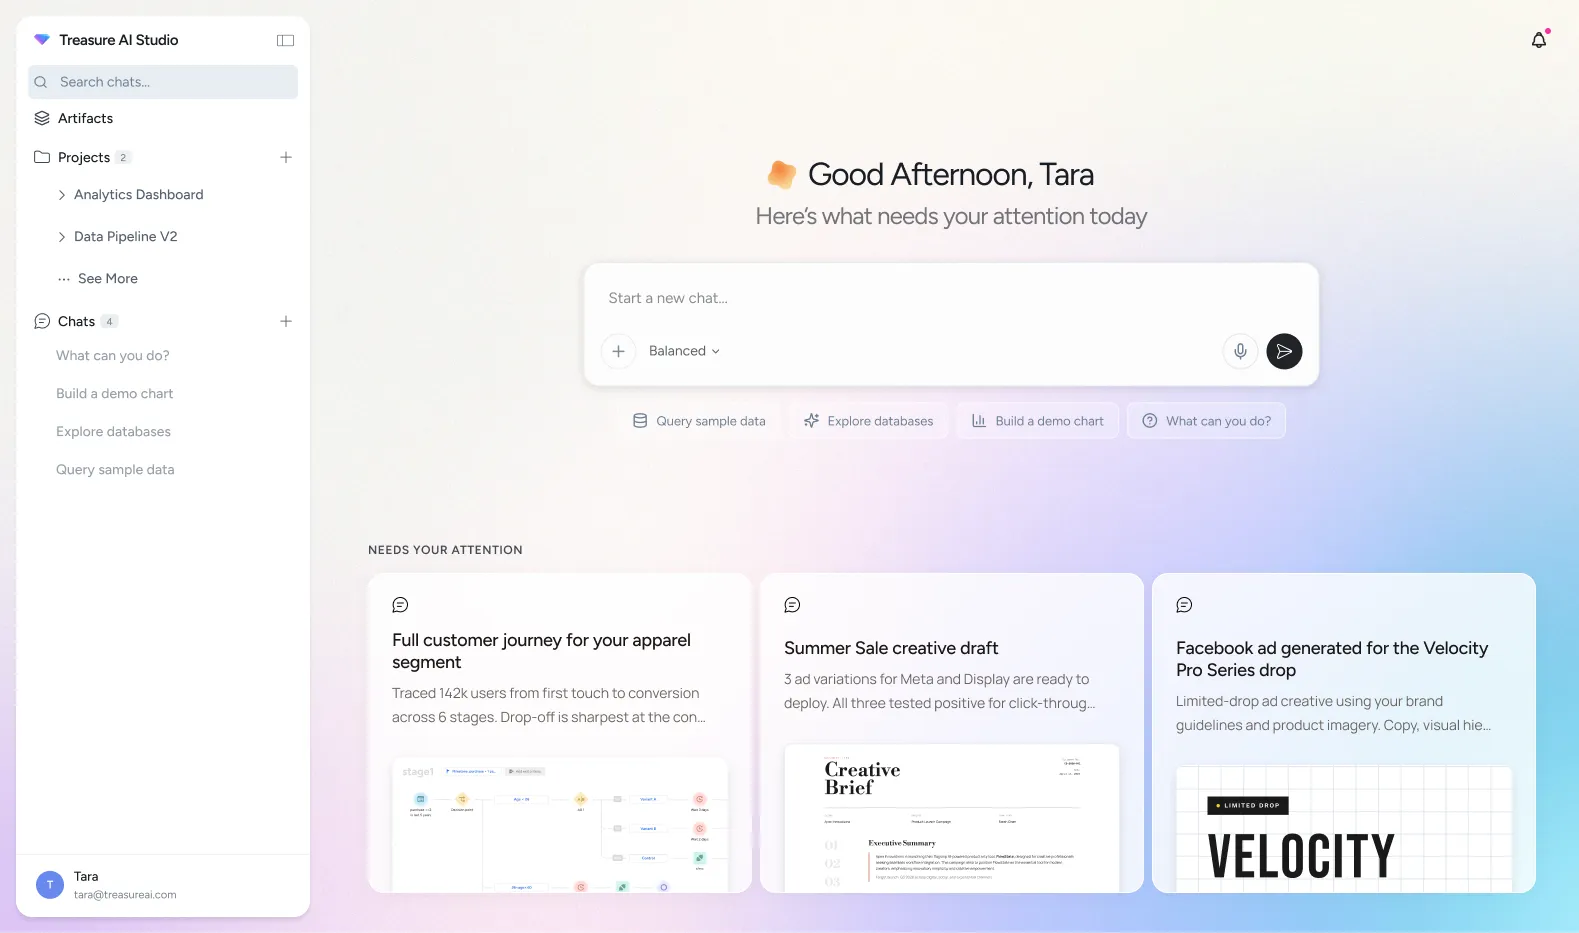
Studio da acceso en lenguaje natural a los datos de clientes, la creación de segmentos, la gestión de campañas y la analítica de datos, y está diseñado para que un usuario sin perfil técnico consulte esos datos y actúe sobre ellos sin SQL ni apoyo de ingeniería.
Los agentes de Studio también consultan datos fuera de Treasure AI. Desde junio de 2026, AI Studio Connections permite explorar y visualizar durante una conversación datos de Snowflake (conector añadido el 25 de junio) o de un lakehouse de Databricks (17 de junio). El 14 de julio se añadió un conector para consultar el propio CDP de Treasure Data y operar flujos de trabajo y segmentos de audiencia desde la conversación. Un administrador registra cada conector una vez por organización mediante OAuth; después, cada usuario autoriza su propia conexión. El agente solo maneja un token de sustitución: la credencial real se inserta en el límite de la red (nota de lanzamiento de junio de 2026). El agente accede únicamente a lo que autoriza el rol del data warehouse. En Snowflake, el conector de AI Studio usa el rol PUBLIC: toda tabla habilitada para el agente también queda visible para los demás usuarios de Snowflake. Conviene delimitar los permisos en consecuencia. Composable Audience Studio, descrito más adelante, usa una credencial de Snowflake configurada por separado.
El contexto de Studio se conserva en carpetas de trabajo, no en conversaciones individuales. Cada carpeta contiene un archivo de instrucciones que la IA lee al iniciar cada conversación y puede actualizar durante el trabajo; así persisten los nombres de tablas, las convenciones y los objetivos (documentación de memoria entre conversaciones). Desde el 17 de septiembre de 2026, una carpeta de trabajo puede compartirse con la cuenta. Los miembros comparten un árbol de archivos con instrucciones, referencias, habilidades y acciones guardadas, pero cada uno trabaja con su propio agente de IA. Si una persona de marketing documenta en la carpeta qué tablas alimentan el informe semanal, qué segmentos se incluyen y cómo presentar los resultados, el agente de otra persona puede partir de ese contexto. Los cambios que cada agente guarda, dentro de los permisos de su usuario, quedan disponibles para la siguiente conversación del equipo.
Compartir la carpeta no comparte las conversaciones: cada una sigue siendo privada, igual que el directorio my/ de cada miembro. Los modos de trabajo determinan si un agente puede escribir en ninguna parte del área compartida, solo en carpetas superiores designadas o en todas. El sistema de archivos aplica esos permisos; no dependen de una instrucción para el modelo. Las personas que gestionan la carpeta controlan el acceso: un administrador de la cuenta sin modo de trabajo asignado no puede leer el contenido (control de acceso).
También se pueden programar flujos de trabajo guardados. Las Work Folder Actions, añadidas el 13 de agosto de 2026, almacenan en una carpeta un flujo repetible para ejecutarlo cuando se necesite. Desde el 25 de agosto de 2026, Action Schedules ejecuta esas acciones a diario, en días laborables, cada semana, cada mes o según un cron personalizado, sin que una persona pulse «Run» (nota de lanzamiento de agosto de 2026). Es ejecución programada, no un disparador por evento: sirve para informes recurrentes, mientras que la respuesta inmediata al comportamiento del cliente depende de la capa en tiempo real.
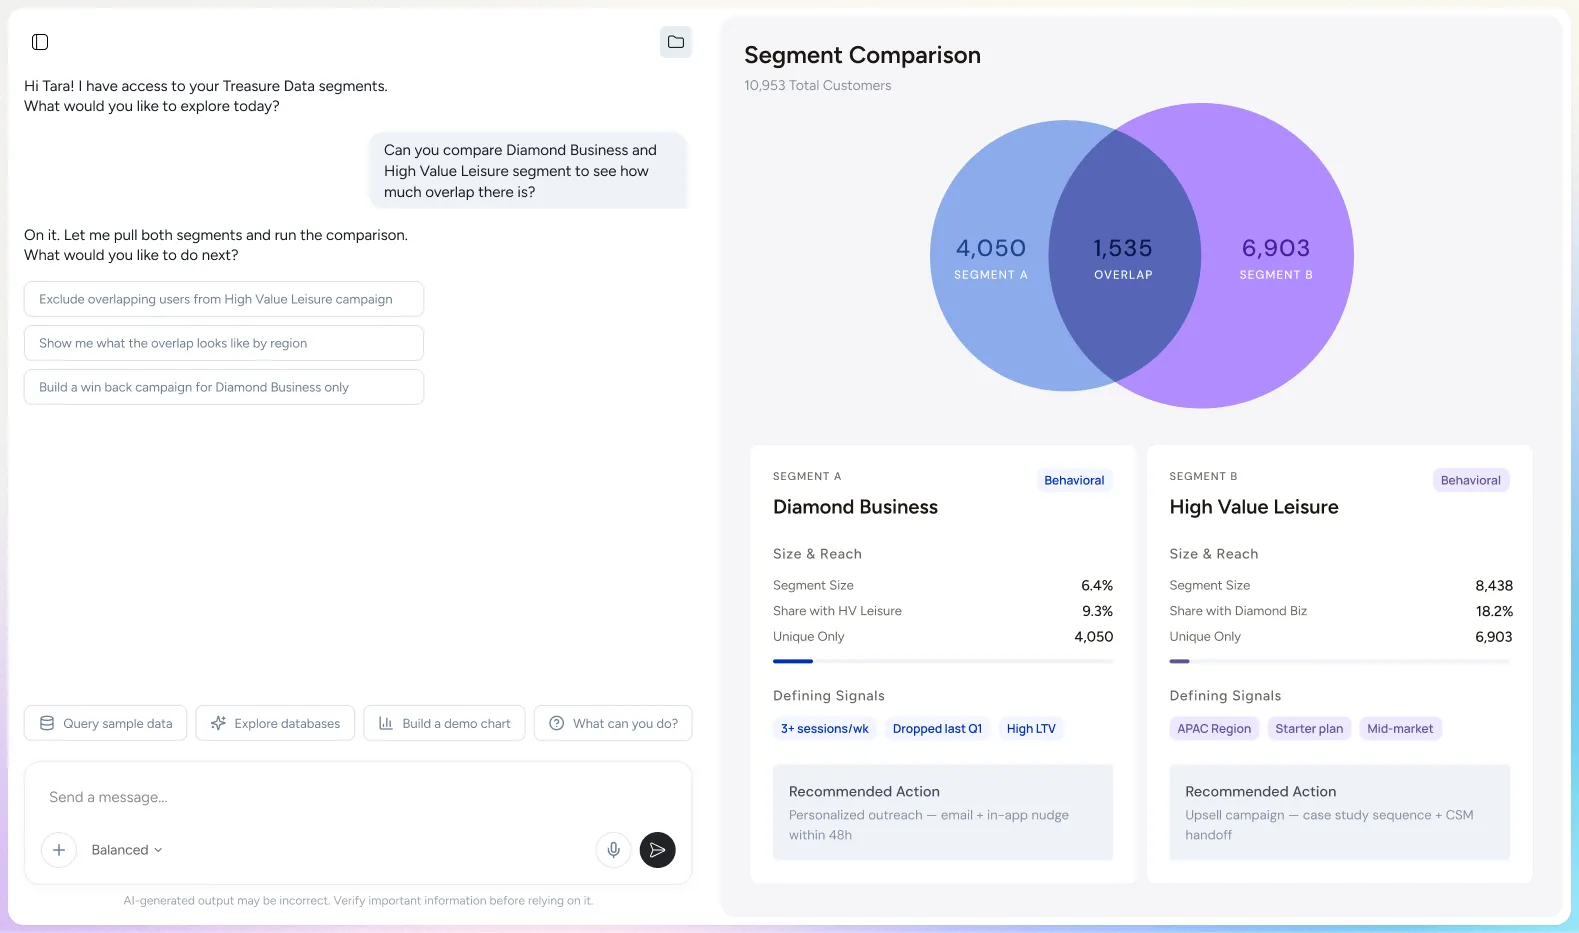
Comparación de segmentos en Treasure AI Studio. Una consulta en lenguaje natural dispara el análisis de solapamiento de audiencias y devuelve las siguientes acciones recomendadas, sin SQL manual ni flujo de inteligencia de negocio.
AI Super Agents
Los AI Super Agents son agentes de IA prefabricados y especializados por dominio, que automatizan flujos de trabajo concretos dentro del Customer Intelligence Loop:
-
AI Super Agent for Marketers: cubre el descubrimiento de audiencias, la creación de campañas, la recomendación de la siguiente mejor acción y la activación entre canales. En lugar de dedicar horas a armar a mano un segmento de recuperación, el responsable de marketing describe el objetivo (“clientes que compraron durante El Buen Fin y no han interactuado en 60 días”) y el agente arma el segmento, elige los canales y lanza la campaña.
-
AI Super Agent for Data Analysts: automatiza la exploración de datos, la generación de hallazgos y la creación de informes. El analista pregunta en lenguaje llano y recibe respuestas estructuradas con visualizaciones de apoyo. Durante el acceso anticipado (early access), un equipo de servicios financieros informó que redujo el tiempo de entrega de informes de tres días a 60 segundos en las consultas de rutina sobre clientes.
Estos agentes se apoyan en la base unificada de datos de clientes de la plataforma, así que operan sobre perfiles completos y ya resueltos, no sobre datos fragmentados en herramientas aisladas.
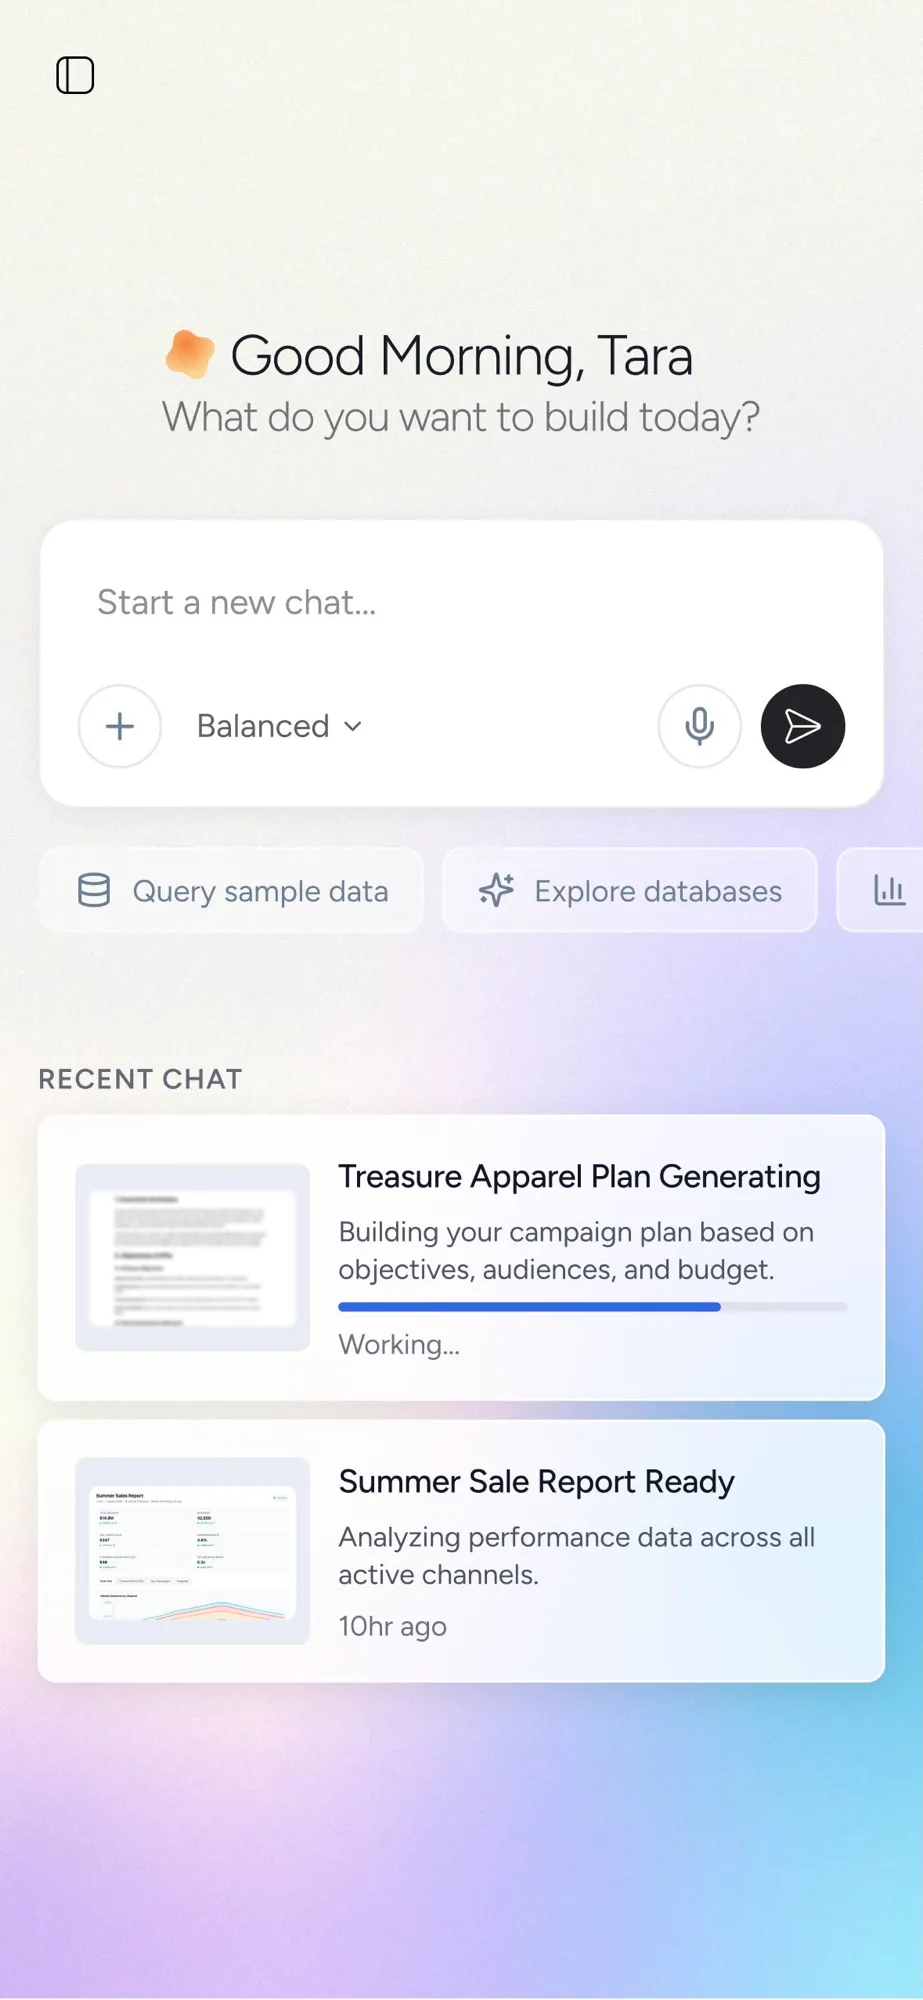
Treasure AI Studio en un dispositivo móvil. La misma interfaz conversacional disponible en iOS y Android, para dar seguimiento a las campañas y aprobar acciones fuera de la oficina.
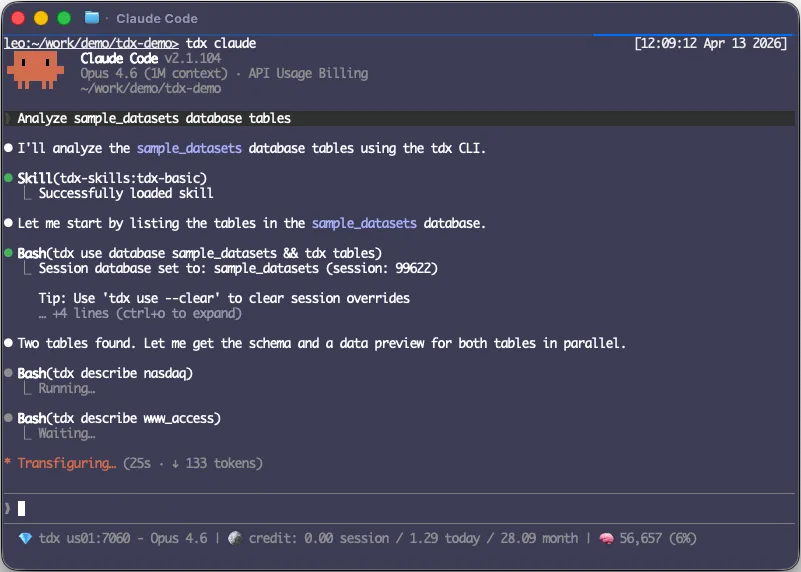
Treasure Code (CLI). Los equipos de ingeniería interactúan con Treasure AI desde una interfaz de terminal construida sobre Claude Code: inspeccionan esquemas, ejecutan consultas y gestionan canalizaciones de datos sin salir de la línea de comandos.
Mensajería omnicanal
La plataforma incluye capacidades nativas de mensajería en estos canales:
- Correo electrónico: contenido personalizado con optimización del horario de envío mediante IA (Email Marketing)
- SMS: mensajes transaccionales y promocionales, con enlaces cortos por destinatario y registro nativo de clics desde septiembre de 2026 (SMS Marketing)
- Push: notificaciones para iOS y Android (Mobile App Marketing)
- Mensaje dentro de la aplicación: mensajes contextuales dentro de las aplicaciones móviles
- LINE: integración nativa con la plataforma de mensajería LINE, relevante para los mercados de Asia-Pacífico; desde agosto de 2026, los mensajes de LINE Official Account (texto, Imagemap y Flex) también se envían como campañas permanentes, junto con el correo electrónico y las notificaciones push
WhatsApp, el canal de relación dominante con el consumidor mexicano, no figura en esa lista de canales nativos. En una evaluación hecha desde México, pregunte al proveedor por qué vía se atiende el canal (integración propia, socio o la API oficial de WhatsApp Business) y cuántos datos de resultado regresan al perfil unificado.
Llevar la mensajería dentro de la plataforma, en lugar de exigir una plataforma de interacción con el cliente aparte, hace que los resultados de interacción (aperturas, clics, conversiones) vuelvan directamente al Customer Intelligence Loop sin la latencia de cruzar la frontera de otro proveedor.
Treasure Data (CDP): la capa de contexto
La base de toda la plataforma es Treasure Data, el CDP que funciona como capa de contexto. En esa capa se ingieren los datos de clientes, se resuelven las identidades, se construyen los perfiles unificados y se aplican las políticas de gobernanza. Todos los productos anteriores (Studio, Super Agents y mensajería) leen y escriben en la capa de contexto.
Capacidades centrales de esa capa:
- Ingesta de datos: más de 170 conectores listos para ingesta por lotes y por streaming desde CRM, comercio electrónico (e-commerce), analítica web, punto de venta, atención al cliente y fuentes de IoT
- Resolución de identidad: correspondencia determinista y probabilística con aprendizaje automático (machine learning), que resuelve identidades entre dispositivos, canales y cuentas
- Perfiles unificados: perfiles persistentes de visión 360° del cliente que agregan datos de comportamiento, de transacción y demográficos en un solo registro
- Toma de decisiones con IA e inteligencia de modelos: análisis predictivo (predictive analytics), puntuación de propensión y procesamiento de señales en tiempo real, que sostienen las etapas ENTENDER y DECIDIR del ciclo
- Gobernanza de datos: control de acceso por campo, aplicación del consentimiento y automatización del cumplimiento en toda la activación posterior
Esa es la capa marcada como “Composable” en el diagrama de arquitectura: la empresa puede conectarla al data warehouse que ya usa mediante el modelo de despliegue híbrido, y los datos siguen residiendo en el warehouse mientras la capa de contexto se encarga de la identidad, la IA y la gobernanza.
La capa de contexto opera en dos modos. Complete CDP es el despliegue totalmente gestionado, en el que los datos se ingieren y se almacenan dentro de la plataforma: conectores listos para usar, resolución de identidad, segmentación y activación sin exigir un data warehouse previo. Composable CDP (Composable Audience Studio) parte del data warehouse: Treasure AI envía consultas federadas a Snowflake, BigQuery o Databricks; el data warehouse las ejecuta con su propio cómputo y devuelve solo los resultados. No hace falta sincronizar las tablas de origen con otro almacenamiento mediante ETL inverso (reverse ETL). El equipo de marketing construye las audiencias de forma visual mientras las tablas de origen permanecen en el data warehouse. Los resultados de la consulta vuelven a Treasure AI y los datos de clientes llegan al destino cuando se activa la audiencia. La plataforma también ofrece resolución de identidad gestionada, toma de decisiones con IA y mensajería nativa. Al compararla con proveedores de Composable CDP, conviene comprobar cuáles de esas funciones ofrece cada opción de forma nativa o mediante integraciones y cuáles están disponibles en el modo de despliegue elegido. Vea la guía de proveedores de CDP.
Composable Audience Studio en Snowflake, Databricks y BigQuery
La cobertura de data warehouses del modo componible cambió durante 2026. Composable Audience Studio llegó a Snowflake y Databricks el 27 de abril de 2026, y a BigQuery el 11 de mayo de 2026 (notas de abril y mayo). Las versiones posteriores incorporaron controles que el equipo de datos necesita comprobar: registro de auditoría comparable al modo gestionado, permisos por segmento, atribución del costo de las consultas y gestión por código.
| Fecha de 2026 | Versión | Qué aporta al equipo de datos |
|---|---|---|
| 27 de abril | Composable Audience Studio para Snowflake y Databricks | Segmentación, puntaje predictivo y activación sobre tablas del data warehouse, sin copiarlas a Treasure AI |
| 11 de mayo | Composable Audience Studio para BigQuery | Segmentación y activación sobre tablas de Google BigQuery |
| 10 de junio | Eventos de auditoría Premium | Registro completo de auditoría, al nivel del Audience Studio gestionado, incluidos los intentos de acceso denegados |
| 30 de junio | Permisos basados en políticas | Acceso total, limitado o nulo por segmento principal componible y por carpeta de segmentos |
| 24 de julio | Creación y actualización con YAML mediante tdx cas push | Audiencias, atributos, comportamientos, segmentos y activaciones gestionados como código, con vista previa antes de aplicar cambios |
| 16 de agosto | Open Catalog Access | Camino inverso: tablas de Complete CDP publicadas en Apache Iceberg como tablas de solo lectura que el data warehouse consulta sin copiarlas (Snowflake y Databricks con disponibilidad general; BigQuery experimental; habilitación a petición) |
| 2 de septiembre | Etiquetas de consulta de Snowflake | QUERY_TAG en JSON para consultas de segmentación, activación, perfiles y operaciones auxiliares; permite atribuir el cómputo a cada audiencia, segmento o activación para seguimiento o imputación de costos |
Cada data warehouse usa un modelo de credenciales propio. Los tres comparten un modelo de datos: un segmento principal componible parte de una tabla de clientes con una fila y un identificador único por perfil, unida en relación uno a muchos a tablas de comportamiento que incluyen una columna temporal (guía de Snowflake).
| Data warehouse | Autenticación | Requisitos de configuración seleccionados |
|---|---|---|
| Snowflake | Autenticación mediante par de claves | Un warehouse para ejecutar consultas; usuario y rol con permiso SELECT en las tablas de destino |
| Databricks | Principal de servicio (service principal) con OAuth | Unity Catalog habilitado; un SQL warehouse o un clúster de cómputo |
| BigQuery | Cuenta de servicio de GCP con clave JSON | Permiso para crear cuentas de servicio y gestionar roles IAM |
El modo componible permite construir audiencias sobre tablas del data warehouse y gobernar el acceso mediante los controles de ese entorno. También traslada costos y trabajo al cliente: las consultas usan el cómputo del data warehouse y el equipo de datos diseña y mantiene los esquemas y ajusta el rendimiento (documentación de Composable CDP). La ausencia de copia de los datos por lotes termina en el punto de activación: si se envía una audiencia a una plataforma publicitaria o a un canal de mensajería, los datos salen del data warehouse. Las organizaciones que prefieren delegar en Treasure AI el almacenamiento y el esquema pueden elegir Complete CDP.
Real-Time 2.0: perfiles en tiempo real y datos en streaming
Un cliente que ya compró en una tienda añade una prenda al carrito y sale del sitio sin terminar la compra. Mientras navega, una oferta puede considerar el carrito actual y el historial de compras; después de la salida, otro disparador puede iniciar un mensaje de seguimiento. Real-Time 2.0 de Treasure AI atiende ambos casos porque envía cada evento entrante por dos caminos simultáneos (descripción de Real-Time). En el camino en tiempo real, el motor de decisiones procesa cada evento en milisegundos, une identidades, actualiza atributos como el conteo de eventos de la sesión y el valor del carrito, y combina la señal en vivo con el perfil almacenado. El camino por lotes ejecuta flujos programados, por lo general con intervalos que van de unos minutos a horas, para agregar el historial de eventos, calcular puntajes predictivos y actualizar las relaciones de identidad. Al procesar un evento, el motor en tiempo real consulta el perfil por lotes más reciente: la decisión dentro de la sesión también tiene en cuenta el historial del cliente.
La unión de identidades ocurre en el propio flujo de eventos. Si los eventos contienen identificadores que coinciden según una clave de unión configurada (un correo electrónico y un ID de cookie en un evento, ese ID de cookie y un ID de dispositivo en el siguiente), el motor agrupa los identificadores en un perfil a medida que llegan, tanto si el cliente ya era conocido como si era anónimo (documentación de unión de identidades). La capa por lotes sigue siendo la referencia para los perfiles históricos.
Treasure AI publica los límites de funcionamiento de la capa en tiempo real (límites de rendimiento):
| Dimensión | Cifra publicada |
|---|---|
| Respuesta de la Personalization API | ≤100 ms en p95 para un máximo de 20 atributos (el acuerdo de nivel de servicio exige Enterprise Support) |
| Activaciones por disparador | Hasta 3 minutos de extremo a extremo, incluida la evaluación, la unión de identidades y el envío |
| Ingesta por streaming | 2000 eventos por segundo por cliente de forma predeterminada; la plataforma escala horizontalmente a más de 100 000 eventos por segundo en todo el mundo, no por cliente |
| Capacidad de toma de decisiones | 8000 eventos por segundo por cliente |
| Límites de identidad | Hasta 100 claves de unión de identidades y 200 identificadores por perfil; al llegar al límite, se expulsa primero el más antiguo |
| Atributos en tiempo real | Hasta 200 por perfil, de 500 bytes cada uno |
Dos versiones de 2026 ampliaron la capa. El Lookup Catalog, del 17 de julio, cruza en tiempo de ejecución los atributos del perfil con una tabla externa de referencia para decisiones por producto, recordatorios de cupones o avisos de ofertas por tiempo limitado. Las tablas de registro de identidad en tiempo real, del 14 de septiembre, guardan los identificadores rechazados en la unión, los expulsados al llegar al límite de 200 y los identificadores entrantes asociados a cada fusión. El equipo de datos puede inspeccionar así cómo se unieron los perfiles.
Las dos cifras de latencia miden procesos distintos. La experiencia dentro del sitio depende de la lectura de la Personalization API, sujeta al acuerdo de ≤100 ms en p95 y a las condiciones indicadas en la tabla. Un mensaje tras el abandono depende de la activación por disparador, cuyo límite publicado es de 3 minutos. Las implementaciones con 100 segmentos principales o más requieren una prueba de concepto previa; una operación limitada a campañas semanales e informes mensuales quizá no necesite la capa en tiempo real.
Caso de cliente publicado en México: Nestlé
Treasure AI publica un caso de cliente sobre Nestlé que cubre las operaciones de México y de Brasil, y que sitúa el inicio de la relación en 2022. Estas son las cifras que el proveedor atribuye a la operación mexicana:
- 4.9 millones de dólares ahorrados en medios pagados y campañas de CRM
- Un aumento de 71 % en la tasa de clics (click-through rate)
- Una reducción de 49 % en el costo por lead (cost per lead)
- 2.3 millones de dólares atribuidos a la eficiencia operativa que habilitó el CDP
- 132 % de la meta de captación de contactos nuevos
Las cinco cifras salen del caso de cliente publicado por Treasure AI y son datos del propio proveedor, sin auditoría independiente. cdp.com no verificó ninguna de esas cifras y no las presenta como referencia del mercado mexicano: describen una implementación concreta, en una empresa concreta, sobre un punto de partida que el caso no detalla. Quien evalúe la plataforma desde México puede pedirle al proveedor la metodología de medición y el periodo comparado antes de trasladar cualquiera de esas cifras a su propio modelo de negocio.
Resultados del acceso anticipado
Durante el acceso anticipado de 2026, Treasure AI publicó dos resultados corporativos:
- Retail corporativo: un cliente de retail comprimió de cinco días a ocho horas el flujo que va de la creación del segmento al lanzamiento de la campaña, con los AI Super Agents. El agente encontró un segmento de alta intención de 340 000 perfiles que el análisis manual no había detectado, y ese segmento produjo un aumento de 23 % en la conversión.
- Servicios financieros: un equipo de analítica de datos sustituyó un ciclo de informes de tres días por consultas en lenguaje natural de 60 segundos en Treasure AI Studio, lo que liberó a los analistas para la interpretación estratégica en lugar de la extracción de datos.
Los dos resultados proceden del propio proveedor y corresponden a despliegues en fase temprana. Todavía no existe validación independiente de analistas ni un conjunto más amplio de referencias de clientes para esos dos casos.
Customer Intelligence Loop
El Customer Intelligence Loop es un ciclo continuo de cinco etapas que describe cómo fluyen los datos de clientes desde la recopilación hasta la activación, y cómo el resultado de la interacción vuelve para mejorar las decisiones siguientes. La mayoría de los stacks de marketing ejecuta ese ciclo en pasos desconectados: un warehouse recopila los datos, una herramienta aparte resuelve las identidades, otra arma los segmentos y otra más envía los mensajes. Cada relevo añade latencia y pierde contexto. El Customer Intelligence Loop es el principio con el que Treasure AI organiza la plataforma para cerrar esas grietas: las cinco etapas se ejecutan dentro de una sola plataforma y los agentes de IA recorren el ciclo de forma continua, en vez de esperar a los lotes que inicia una persona.
RECOPILAR → UNIFICAR → ENTENDER → DECIDIR → INTERACTUAR → (vuelta a RECOPILAR)
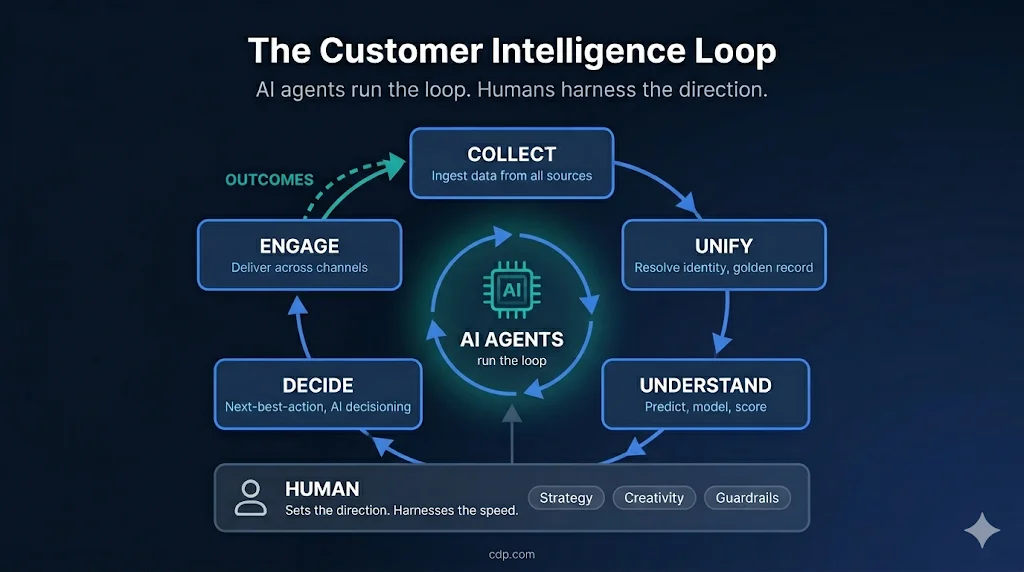
Cada etapa corresponde a capacidades concretas de la plataforma:
| Etapa | Qué ocurre | Capacidad de la plataforma |
|---|---|---|
| RECOPILAR | Ingerir datos de cualquier fuente: comportamiento, transacción, CRM, atención al cliente, IoT | Más de 170 conectores listos, ingesta por streaming y por lotes |
| UNIFICAR | Resolver identidades entre dispositivos, canales y cuentas en perfiles unificados | Resolución de identidad con aprendizaje automático, correspondencia determinista y probabilística |
| ENTENDER | Analizar el comportamiento del cliente, predecir la intención y calcular la propensión | Análisis predictivo, modelado del valor del ciclo de vida del cliente, predicción de churn |
| DECIDIR | Determinar la siguiente mejor acción para cada cliente | Motor de decisión con IA, arbitraje de ofertas en tiempo real |
| INTERACTUAR | Ejecutar experiencias personalizadas en todos los canales | Mensajería omnicanal nativa, activación de datos hacia sistemas externos |
Los resultados de la interacción (aperturas de correo, conversiones de compra, contactos con atención al cliente) vuelven a la etapa RECOPILAR y cierran el ciclo. En el modelo agéntico, los agentes de IA recorren ese ciclo de forma continua, en lugar de esperar a las campañas que inicia una persona. Para una operación que ejecuta campañas semanales por lotes, sin exigencia de personalización en tiempo real ni dentro de la sesión, el ciclo continuo puede no ser necesario: una arquitectura componible que recorra el ciclo con cadencia diaria o semanal entrega valor suficiente con menos complejidad.
Gobernanza y seguridad
La gobernanza de datos corporativa es un requisito de base para cualquier plataforma que trate datos personales a escala. Las capacidades de gobernanza de Treasure AI incluyen:
- Certificaciones de cumplimiento: SOC 2 Tipo II, RGPD (GDPR), CCPA y elegibilidad para HIPAA
- Infraestructura: opera sobre AWS, con integración a Bedrock para las cargas de trabajo de IA
- Registro de auditoría: bitácora a prueba de alteraciones de todo acceso a datos, acción de agente y evento de activación
- Gestión del consentimiento: aplicación centralizada del consentimiento en todos los canales de activación
- Residencia de datos: opciones de almacenamiento regional para organizaciones sujetas a requisitos de localización de datos
- Instrucciones generales para agentes: los administradores pueden fijar hasta 16 384 caracteres de instrucciones permanentes, añadidas al prompt de sistema de cada agente de AI Studio en las conversaciones nuevas. Orientan la conducta del agente; el acceso a los datos sigue sujeto a los controles obligatorios descritos arriba, no a esas instrucciones
- Política de datos para IA: los datos de clientes no se usan para entrenar modelos de IA
Para la lista completa de certificaciones y la documentación de seguridad, vea el Treasure AI Trust Center.
Una operación mexicana necesita leer esa lista con un cuidado adicional. La LFPDPPP (Ley Federal de Protección de Datos Personales en Posesión de los Particulares), publicada en el Diario Oficial de la Federación el 20 de marzo de 2025 y vigente desde el día siguiente, no aparece entre las certificaciones, que cubren el par estadounidense y europeo. Pida al proveedor el mapeo de cada finalidad de tratamiento con el aviso de privacidad que exige la LFPDPPP, el flujo de atención a los derechos del titular y la región de almacenamiento aplicable al contrato; la autoridad que vigila el cumplimiento y sanciona es la Secretaría Anticorrupción y Buen Gobierno, a la que la propia ley atribuye esas facultades. En España y en la Unión Europea rige el RGPD, con la AEPD como autoridad de control, y la CCPA es la referencia estadounidense.
El registro de auditoría a prueba de alteraciones importa sobre todo en los sectores regulados: las organizaciones de servicios financieros y de salud necesitan un registro demostrable de quién consultó los datos de clientes, o de qué agente lo hizo, y de qué acciones se ejecutaron.
Quién debería considerar Treasure AI
Treasure AI encaja mejor en organizaciones que:
- Necesitan el Customer Intelligence Loop completo en una sola plataforma: ingesta de datos, resolución de identidad, toma de decisiones con IA y activación sin encadenar varios proveedores
- Quieren agentes de IA operando sobre datos de clientes unificados: no solo tableros para personas, sino una arquitectura centrada en agentes en la que la IA ejecuta de forma continua
- Exigen gobernanza de nivel corporativo: cumplimiento de HIPAA, SOC 2, RGPD y CCPA, con acciones de agente auditables
- Operan en varios canales: correo electrónico, SMS, push, mensaje dentro de la aplicación, LINE, personalización web y activación de medios pagados
- Ya invirtieron en un data warehouse: Composable Audience Studio construye y activa audiencias sobre las tablas de Snowflake, Databricks y BigQuery sin moverlas; los agentes de AI Studio también consultan Snowflake y Databricks directamente durante una conversación
- Atienden mercados de Asia-Pacífico: integración nativa con LINE y opciones de residencia regional de datos
Organizaciones para las que otra arquitectura puede encajar mejor:
- Equipos que solo necesitan ETL inverso: una operación con data warehouse maduro, lógica de segmentación ya escrita en SQL y ninguna necesidad de resolución de identidad, de toma de decisiones con IA ni de mensajería nativa suele resolverse con una herramienta aislada de ETL inverso. La arquitectura híbrida de Treasure AI se conecta a esos mismos warehouses, pero la plataforma completa puede ser más capacidad de la necesaria
- Organizaciones comprometidas por entero con una sola suite (solo Adobe o solo Salesforce) pueden encontrar una integración más estrecha dentro de ese ecosistema, pese a las contrapartidas del suite tax. Quien opera Salesforce y Adobe a la vez, o mezcla productos de suite con herramientas especializadas, tiene que decidir si unifica los datos en el CDP de una de las dos suites o en una plataforma independiente de ambas
- Empresas pequeñas con necesidades simples de datos (menos de 100 000 perfiles, uno o dos canales) pueden no necesitar las capacidades corporativas de la plataforma
FAQ
¿Qué pasó con Treasure Data?
Treasure Data cambió de marca a Treasure AI el 20 de abril de 2026. El dominio de la empresa pasó de treasuredata.com a treasure.ai, y el producto evolucionó de plataforma de datos de clientes a plataforma de experiencia agéntica. Las integraciones, las API y los SDK de los clientes existentes siguen siendo retrocompatibles: el cambio de marca refleja una evolución del producto, no una ruptura de compatibilidad.
¿Treasure AI es un CDP o algo distinto?
Treasure AI incluye un CDP completo (ingesta de datos, resolución de identidad, segmentación y activación) y lo extiende con mensajería nativa y capacidades de agente de IA. La etiqueta “plataforma de experiencia agéntica” refleja la suma de la decisión y la ejecución con IA sobre esa base. Quien evalúe Treasure AI frente a otros CDP debe comparar el alcance completo de la plataforma, no solo la capa de unificación de datos. Vea qué es un CDP agéntico.
¿Treasure AI es un CDP en tiempo real?
Sí: Real-Time 2.0 de Treasure AI procesa eventos en streaming en milisegundos, une identidades a medida que llegan y ofrece un acuerdo de nivel de servicio de ≤100 ms en p95 para consultar hasta 20 atributos mediante la Personalization API, con Enterprise Support. Las activaciones por disparador se entregan en un máximo de 3 minutos. En paralelo, los procesos por lotes calculan puntajes predictivos y actualizan las relaciones de identidad; el motor en tiempo real consulta ese perfil histórico al procesar cada evento.
¿Treasure AI funciona con Snowflake, Databricks y BigQuery?
Sí: Composable Audience Studio de Treasure AI construye y activa audiencias directamente sobre tablas de Snowflake, Databricks y BigQuery sin copiar las tablas de origen a Treasure AI. Las consultas usan el cómputo del data warehouse del cliente, que asume ese costo y mantiene los esquemas. Los agentes de AI Studio también pueden consultar Snowflake y Databricks durante una conversación mediante conexiones OAuth autorizadas por cada usuario. Al activar una audiencia, los datos de clientes sí llegan al destino elegido.
¿En qué se diferencia Treasure AI de otros CDP?
Treasure AI reúne el CDP, la mensajería omnicanal y los agentes de IA en una sola plataforma que ejecuta el Customer Intelligence Loop de forma continua. La mayoría de los CDP resuelve la unificación de datos y la segmentación, pero exige herramientas aparte para la mensajería y la toma de decisiones con IA: de cuatro a cinco proveedores en un stack componible. Treasure AI mantiene las cinco etapas dentro de una plataforma, lo que evita la duplicación de datos personales del ETL inverso.
¿Es Treasure AI el CDP adecuado para mi organización?
Treasure AI es el CDP adecuado para empresas globales y multimarca, B2C y B2B, con datos a gran escala y necesidad de cobertura en Asia-Pacífico, y es la elección equivocada para equipos pequeños o que dependen del autoservicio de marketing. Elíjalo por el alcance que cubre sola la plataforma: despliegue empaquetado o componible, IA predictiva y agéntica nativa, y correo electrónico, SMS y push nativos. Descártelo si necesita simplicidad de autoservicio o tiene presupuesto de pequeña y mediana empresa.
¿Qué alternativas hay a Treasure AI en México?
Adobe Real-Time CDP, Salesforce Data Cloud y Twilio Segment son las alternativas que este sitio cubre para el mercado mexicano. Adobe Real-Time CDP encaja en organizaciones que ya operan Adobe Experience Cloud; Salesforce Data Cloud, en las que tienen Sales Cloud o Service Cloud como sistema de registro; Twilio Segment, en equipos de producto y crecimiento que priorizan la recopilación de eventos y el enrutamiento hacia muchos destinos.
Vea cómo evalúan los analistas a los proveedores de CDP → IDC MarketScape | Forrester Wave
Este artículo también está disponible en: What Is Treasure AI (Formerly Treasure Data)? · Treasure AI(旧Treasure Data)とは?特徴と沿革 · O que é Treasure AI (ex-Treasure Data)? · Treasure Data (Treasure AI) : la CDP, ses limites · Treasure AI: CDP-Profil für Deutschland