Treasure AI (anciennement Treasure Data) est une plateforme d’expérience agentique (agentic experience platform) qui unifie les données clients de n’importe quelle source, résout les identités entre les canaux et déploie des agents IA pour exécuter de façon autonome la personnalisation, la messagerie et la décision, sous la direction des équipes, qui apportent la créativité et le jugement stratégique.
La plateforme a débuté comme l’une des premières CDP (plateforme de données client, customer data platform) et réunit aujourd’hui la CDP, la messagerie omnicanale (omnichannel messaging) et l’IA dans un seul produit, pour exécuter le Customer Intelligence Loop en continu.
Transparence : cdp.com est édité par Treasure Data (aujourd’hui Treasure AI). Ce profil applique les mêmes critères éditoriaux que les autres profils d’éditeur du site, documentés dans la politique éditoriale, et le lecteur doit connaître cette relation. Pour la comparaison des éditeurs de CDP, voir le guide comparatif des éditeurs de CDP.
Treasure AI en bref
| Dimension | Treasure AI |
|---|---|
| Idéal pour | Les groupes internationaux et multimarques, B2C comme B2B, dont les volumes de données sont importants et qui ont besoin d’une couverture Asie-Pacifique (APAC) et d’une résidence des données dans plusieurs régions |
| Taille type de l’entreprise | Entreprises de taille intermédiaire et grands comptes : 39,9 % des 163 avis G2 classés par taille d’entreprise proviennent d’organisations de plus de 1 000 salariés, 36,8 % de 51 à 1 000 salariés et 23,3 % de 50 salariés ou moins |
| Modèle de tarification | Par profil et par événement, sur devis ; pas de coût de calcul distinct pour les requêtes et la segmentation en mode Complete CDP. En mode Composable, les requêtes consomment les ressources de calcul du data warehouse du client, facturées par son éditeur |
| Déploiement type | De 4 à 8 semaines pour la première phase ; de 3 à 6 mois pour un déploiement complet à l’échelle du groupe |
| Différenciateur principal | Déploiement packagé ou composable, IA prédictive et agentique native, e-mail, SMS et push dans une seule plateforme, avec des connecteurs propres à l’Asie-Pacifique (LINE, Yahoo! JAPAN Ads) |
| À écarter si | L’équipe marketing cherche la simplicité d’un outil en libre-service, ou le budget est celui d’une PME |
La répartition ci-dessus décrit qui publie les avis, et non la clientèle de l’éditeur. Les auteurs d’avis se choisissent eux-mêmes et les éditeurs organisent des campagnes de collecte d’avis ; les comptages correspondent au sous-ensemble que G2 classe par taille, plus petit que le total d’avis cité ailleurs sur la page, et, lorsqu’une page ne présente aucune répartition par taille, la ligne s’appuie sur le fait structurel qu’elle énonce. La comparaison entre éditeurs et la méthode de calcul de ces répartitions figurent dans le guide comparatif des éditeurs de CDP.
Pour les modèles de tarification des CDP et les postes de coût à budgéter, voir le guide des prix d’une CDP.
Histoire de l’entreprise
Treasure Data a été fondée en 2011 à Mountain View, en Californie, comme plateforme de gestion de données dans le cloud pour les journaux d’activité (logs) et l’analyse de données massives (big data). Dans les années qui ont suivi, l’entreprise a déplacé son centre de gravité vers les données clients et a construit l’infrastructure d’ingestion de données, de résolution d’identité (identity resolution) et d’activation des audiences à grande échelle qui est devenue sa plateforme de données client.
Principales étapes :
| Année | Étape |
|---|---|
| 2011 | Création à Mountain View, en Californie, comme plateforme de gestion de données massives |
| 2013 | Extension à la gestion des données clients en entreprise |
| 2018 | Rachat par Arm Holdings (groupe SoftBank) pour environ 600 millions de dollars américains, qui accélère l’implantation auprès des grands comptes |
| 2020 | Nommée Leader du Forrester Wave consacré aux Customer Analytics Technologies |
| 2022 | Nommée Strong Performer du Forrester Wave consacré aux CDP |
| 2024 | Nommée Leader du Forrester Wave 2024 consacré aux CDP, pour la solidité de son socle de données et son passage à l’échelle en entreprise |
| 2026 | Changement de marque de Treasure Data en Treasure AI, et lancement de la plateforme d’expérience agentique |
| 2026 | Nommée Leader de l’IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2C Users (doc n° US53952526) |
| 2026 | Nommée Leader de l’IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2B Users (doc n° US53952326), distinction partagée avec Salesforce |
Selon les chiffres publiés par l’entreprise, Treasure AI sert en 2026 plus de 400 grands comptes dans le retail, les services financiers, la santé, l’automobile, les produits de grande consommation et les médias, et traite des milliards de profils clients unifiés dans le monde.
Le changement de marque : de Treasure Data à Treasure AI
Le 20 avril 2026, Treasure Data est officiellement devenue Treasure AI. Le domaine de l’entreprise est passé de treasuredata.com à treasure.ai, et la catégorie de produit est passée de « customer data platform » à « agentic experience platform ».
Ce changement de marque traduit une modification structurelle de ce que fait la plateforme. Treasure Data a commencé comme un système où des humains consultaient des données clients unifiées pour décider des actions marketing. Treasure AI est conçue comme un système où les agents IA consultent ces mêmes données pour décider et exécuter de façon autonome, pendant que les équipes définissent la stratégie, produisent la création et posent les garde-fous (guardrails).
Trois changements définissent la transition :
-
De la plateforme de données à la plateforme d’expérience. La CDP d’origine traitait l’ingestion, l’unification et l’activation des audiences. La nouvelle plateforme ajoute la messagerie omnicanale native (e-mail, SMS, push mobile, message in-app, LINE), la décision par l’IA et la personnalisation en temps réel, et supprime le besoin de recourir à un éditeur différent à chaque étape du Customer Intelligence Loop.
-
D’une architecture centrée sur l’humain à une architecture centrée sur les agents. L’interface principale de la plateforme passe des tableaux de bord (dashboards) et des générateurs de requêtes à des agents IA qui opèrent par MCP (Model Context Protocol), CLI, API et compétences d’agent prêtes à l’emploi. Les équipes gardent la direction de la stratégie ; les agents IA prennent en charge l’exécution à grande échelle.
-
Des cycles par lots aux boucles continues. La CDP exécutait la segmentation client par lots quotidiens ou hebdomadaires. La plateforme d’expérience agentique exécute le Customer Intelligence Loop en continu : COLLECTER, UNIFIER, COMPRENDRE, DÉCIDER et ENGAGER en quelques minutes, et le résultat de l’engagement revient orienter le cycle suivant.
Les API, les SDK et les workflows existants restent rétrocompatibles. Le changement de marque est une évolution de produit, pas une migration qui interrompt les intégrations en production.
Architecture de la plateforme
Treasure AI utilise une architecture hybride qui sépare le plan de contrôle du plan de données.
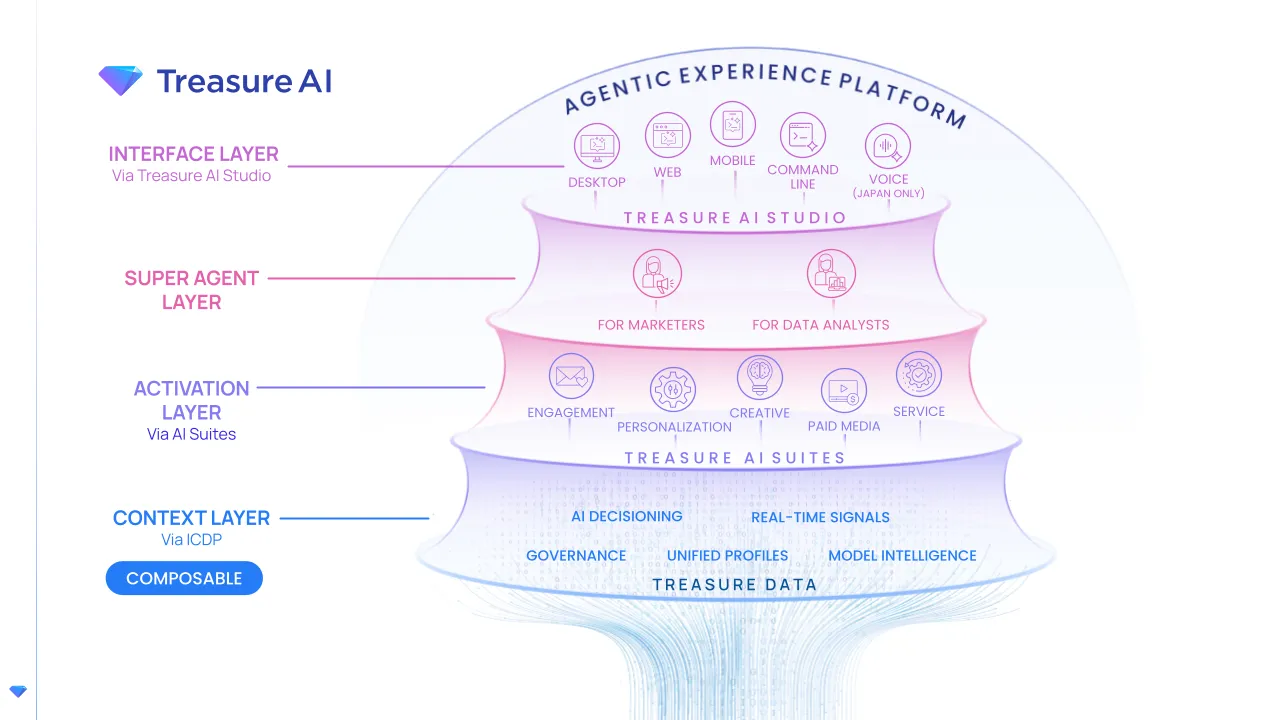
Architecture de la plateforme d’expérience agentique de Treasure AI. La plateforme est composable à la couche de contexte (iCDP) et regroupe au-dessus l’activation, les agents IA et les interfaces.
-
Plan de contrôle (Treasure AI) : résolution d’identité, segmentation des audiences, décision par l’IA, orchestration de la messagerie et environnement d’exécution des agents IA. C’est la couche managée de la plateforme, où s’exécute le Customer Intelligence Loop.
-
Plan de données (infrastructure du client) : les données client peuvent rester dans le data warehouse (entrepôt de données) du client, sur Snowflake, Databricks ou BigQuery. Treasure AI interroge les tables sur place, sans exiger leur transfert vers un stockage propriétaire. Dans l’autre sens, ces mêmes data warehouses peuvent interroger les tables gérées par Treasure AI, publiées en lecture seule au format Apache Iceberg, sans seconde copie.
Ce modèle de déploiement hybride répond à un choix d’architecture : où conserver les données et comment exposer les profils pour l’activation. Les CDP composables conservent les données dans le data warehouse ; leur latence dépend de la fraîcheur des données et de la configuration de la couche qui expose les profils. Les CDP packagées gèrent le stockage et l’exécution dans leur propre infrastructure. Treasure AI propose les deux modes, avec un plan de contrôle managé conçu pour l’accès aux profils à faible latence et l’activation en temps réel.
Produits principaux
Treasure AI Studio
Treasure AI Studio est l’interface principale de la plateforme, disponible sur plusieurs supports :
- Web : espace de travail dans le navigateur pour le marketing, l’analyse et les équipes data
- Poste de travail : application native pour macOS et Windows
- Mobile : iOS et Android, pour le suivi et les validations en déplacement
- CLI (Treasure Code) : interface en ligne de commande pour que les équipes d’ingénierie et de data interagissent avec la plateforme par programmation. Treasure Code est construit sur Claude Code et donne un accès depuis le terminal aux données clients, à l’inspection des schémas et aux opérations de pipeline
- Voix (Treasure AI Voice) : interface vocale à base d’IA pour interroger les données et prendre des notes en mains libres
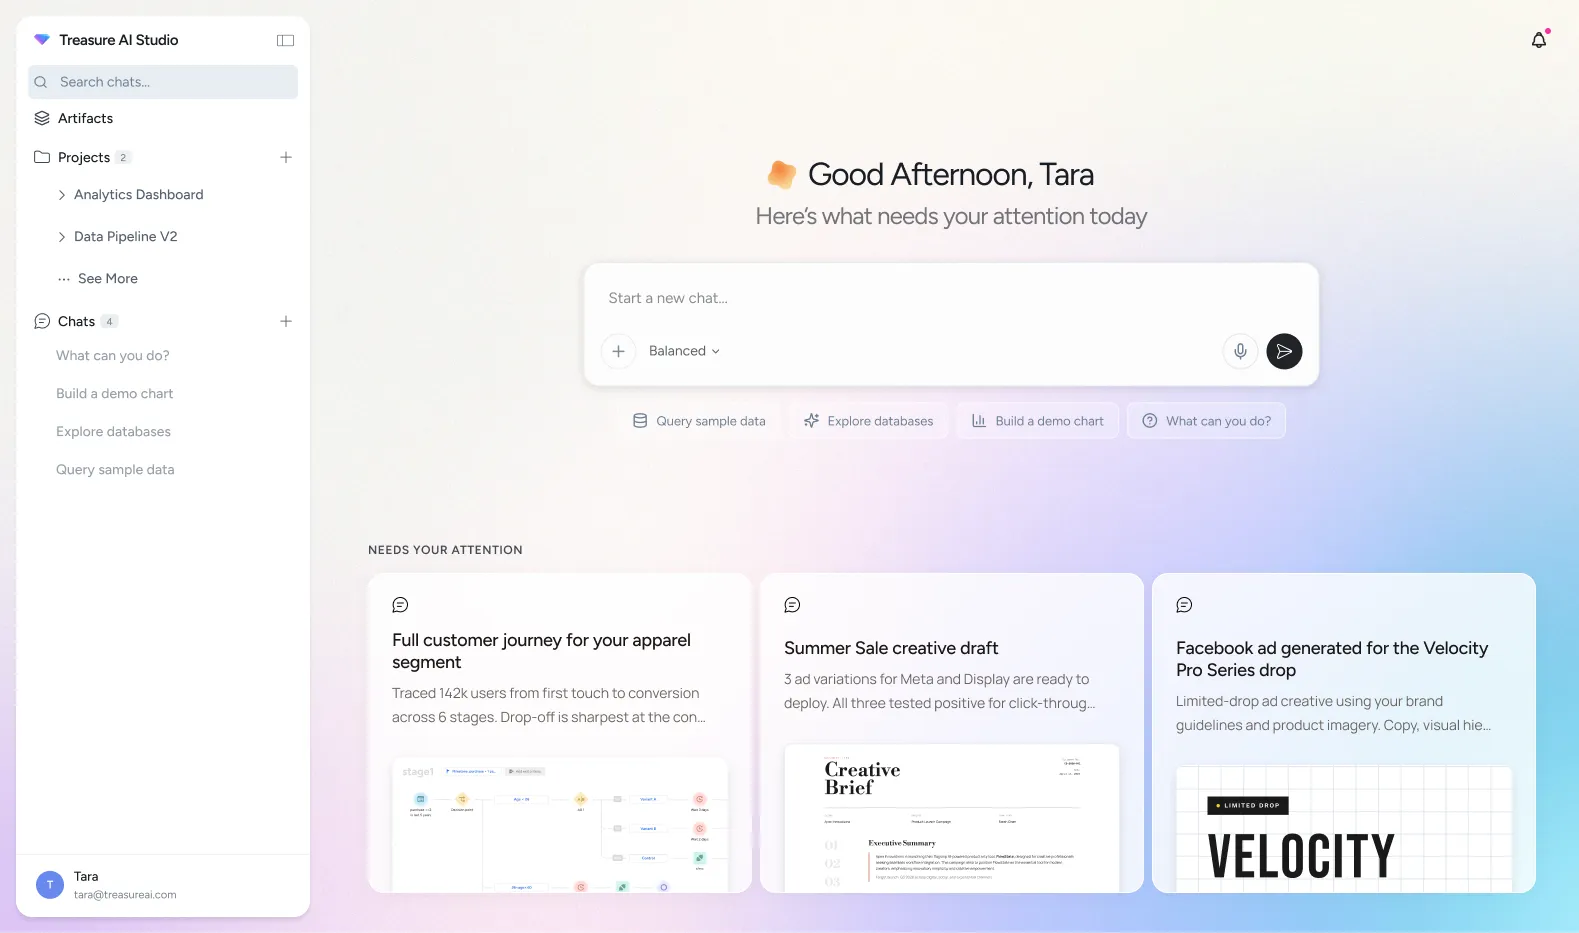
Studio donne un accès en langage naturel aux données clients, à la création de segments, à la gestion des campagnes et à l’analyse, et vise un usage sans SQL ni appui de l’ingénierie pour les utilisateurs non techniques.
Les agents de Studio ne se limitent pas aux données stockées dans Treasure AI. Depuis juin 2026, les connexions d’AI Studio donnent à l’agent accès aux données d’un data warehouse Snowflake (depuis le 25 juin) ou d’un lakehouse Databricks (depuis le 17 juin). L’agent peut explorer ces données et les représenter graphiquement pendant une conversation. Un connecteur ajouté le 14 juillet donne aussi accès à la CDP Treasure Data : l’agent peut lancer des requêtes, des workflows et des opérations sur les segments d’audience pendant la conversation.
Un administrateur enregistre chaque connecteur une fois pour l’organisation par OAuth, puis chaque utilisateur autorise sa propre connexion. L’agent ne manipule qu’un jeton de substitution ; l’identifiant réel n’est inséré qu’au moment de l’appel réseau (note de version de juin 2026). Les droits de l’agent se limitent à ceux du rôle autorisé sur le data warehouse. Le connecteur Snowflake d’AI Studio utilise toutefois le rôle PUBLIC : toute table accessible à l’agent par ce rôle l’est aussi à tous les autres utilisateurs Snowflake. L’équipe data doit donc restreindre les droits accordés à ce rôle. Composable Audience Studio, décrit plus bas, utilise un identifiant Snowflake configuré séparément.
Le contexte de Studio se conserve dans les dossiers de travail, et non dans les seules conversations. Chaque dossier contient un fichier d’instructions que l’IA lit à l’ouverture d’une conversation et peut actualiser au fil du travail ; les noms de tables, les conventions et les objectifs se transmettent ainsi d’une session à l’autre (documentation sur la mémoire entre conversations). Depuis le 17 septembre 2026, un dossier peut être partagé dans le compte. Ses membres consultent le même ensemble de fichiers — instructions, références, compétences et actions enregistrées — avec chacun son propre agent IA. Par exemple, une responsable marketing décrit dans le dossier comment construire le rapport hebdomadaire de campagne : tables à utiliser, segments à compter et format du résultat. L’agent d’une collègue retrouve ces règles sans recréer le cahier des charges. Quand les droits le permettent, les modifications enregistrées par un membre deviennent le contexte de travail de la conversation suivante.
Le partage du dossier n’ouvre pas toutes les données. Les conversations et le répertoire my/ de chaque membre restent privés. Les modes de travail déterminent où l’agent de chacun peut écrire : nulle part dans le dossier partagé, dans certains dossiers de premier niveau ou partout. Le système de fichiers applique ces restrictions, pas les seules instructions données à l’agent. Les responsables du dossier gèrent les droits d’accès : un administrateur du compte sans mode de travail dans ce dossier ne peut pas en lire le contenu (contrôle d’accès).
Les actions enregistrées dans un dossier peuvent aussi être planifiées. Les Work Folder Actions, depuis le 13 août 2026, enregistrent un workflow récurrent qui peut être relancé à la demande. Les Action Schedules, depuis le 25 août 2026, exécutent ces actions chaque jour, les jours ouvrés, chaque semaine, chaque mois ou selon une expression cron, sans lancement manuel (note de version d’août 2026). Cette planification libère l’équipe des analyses et rapports récurrents ; elle ne remplace pas la couche temps réel pour réagir à un comportement client dès qu’il se produit.
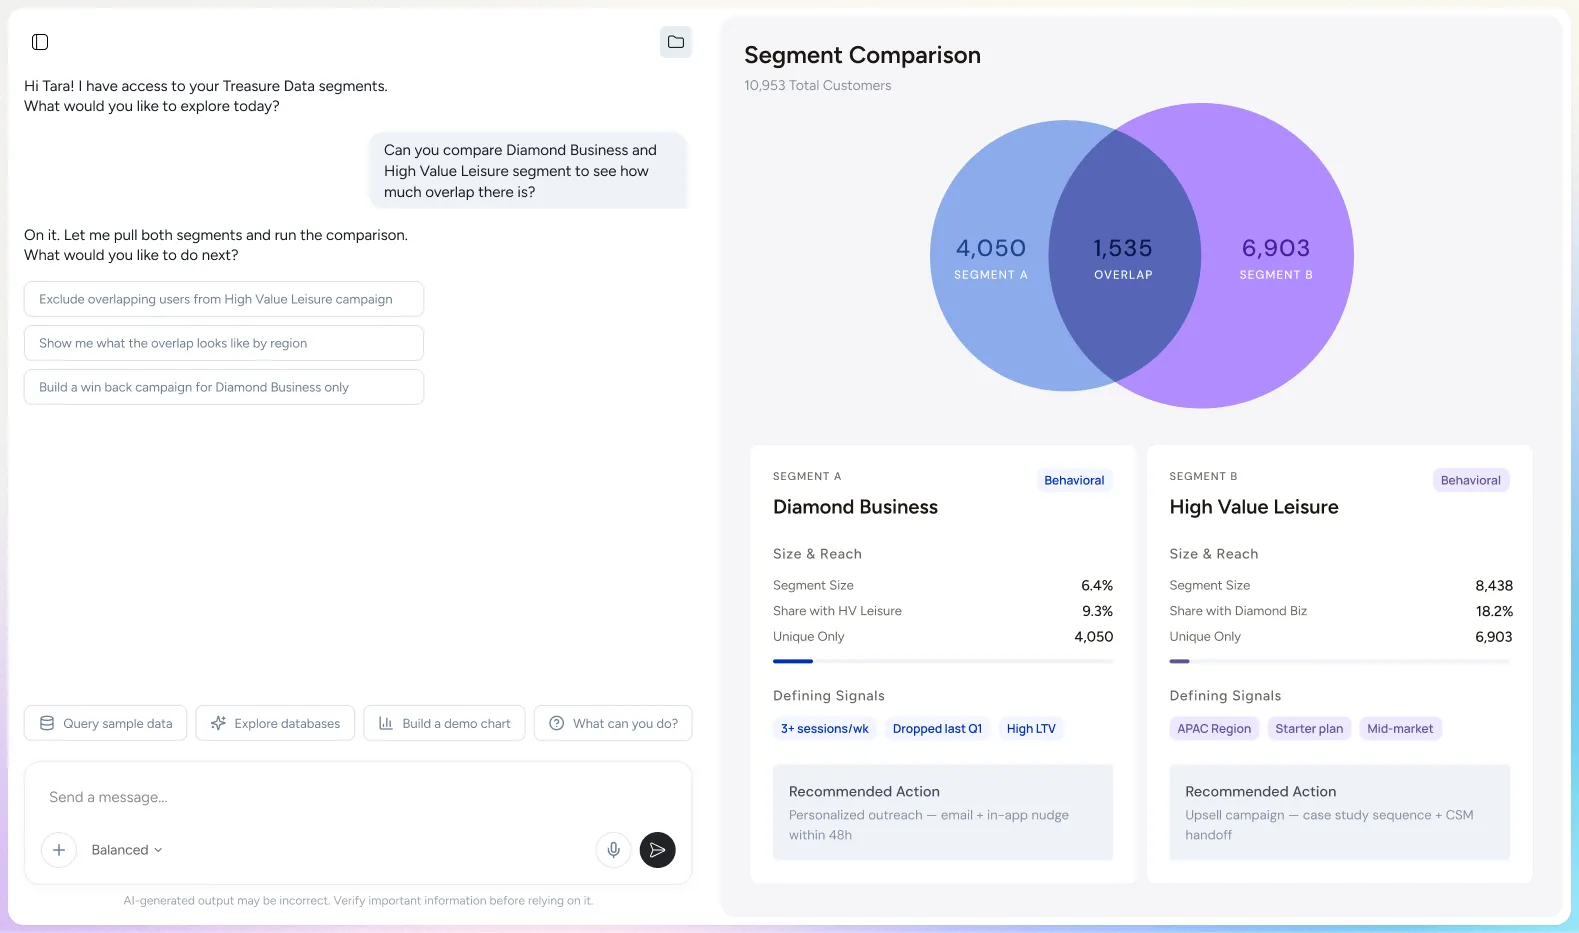
Comparaison de segments dans Treasure AI Studio. Une requête en langage naturel déclenche l’analyse du recouvrement des audiences et renvoie les actions recommandées, sans SQL manuel ni détour par l’informatique décisionnelle.
AI Super Agents
Les AI Super Agents sont des agents IA prêts à l’emploi, spécialisés par domaine, qui automatisent des tâches précises du Customer Intelligence Loop :
-
AI Super Agent for Marketers : découverte d’audiences, création de campagnes, recommandation de la meilleure action suivante (next best action) et activation cross-canal. Au lieu de construire à la main un segment de reconquête pendant des heures, le responsable marketing décrit l’objectif — « les clients qui ont acheté pendant les soldes d’hiver et qui n’ont pas réagi depuis 60 jours » — et l’agent construit le segment, choisit les canaux et lance la campagne.
-
AI Super Agent for Data Analysts : exploration des données, production d’analyses et rédaction de rapports. L’analyste pose ses questions en langage courant et reçoit des réponses structurées avec les visualisations correspondantes. En accès anticipé (early access), une équipe de services financiers a rapporté avoir ramené son délai de production de rapports de trois jours à 60 secondes pour les demandes clients courantes.
Ces agents s’appuient sur le socle de données clients unifiées de la plateforme, donc sur des profils complets et déjà résolus plutôt que sur des données éparpillées entre des outils cloisonnés.
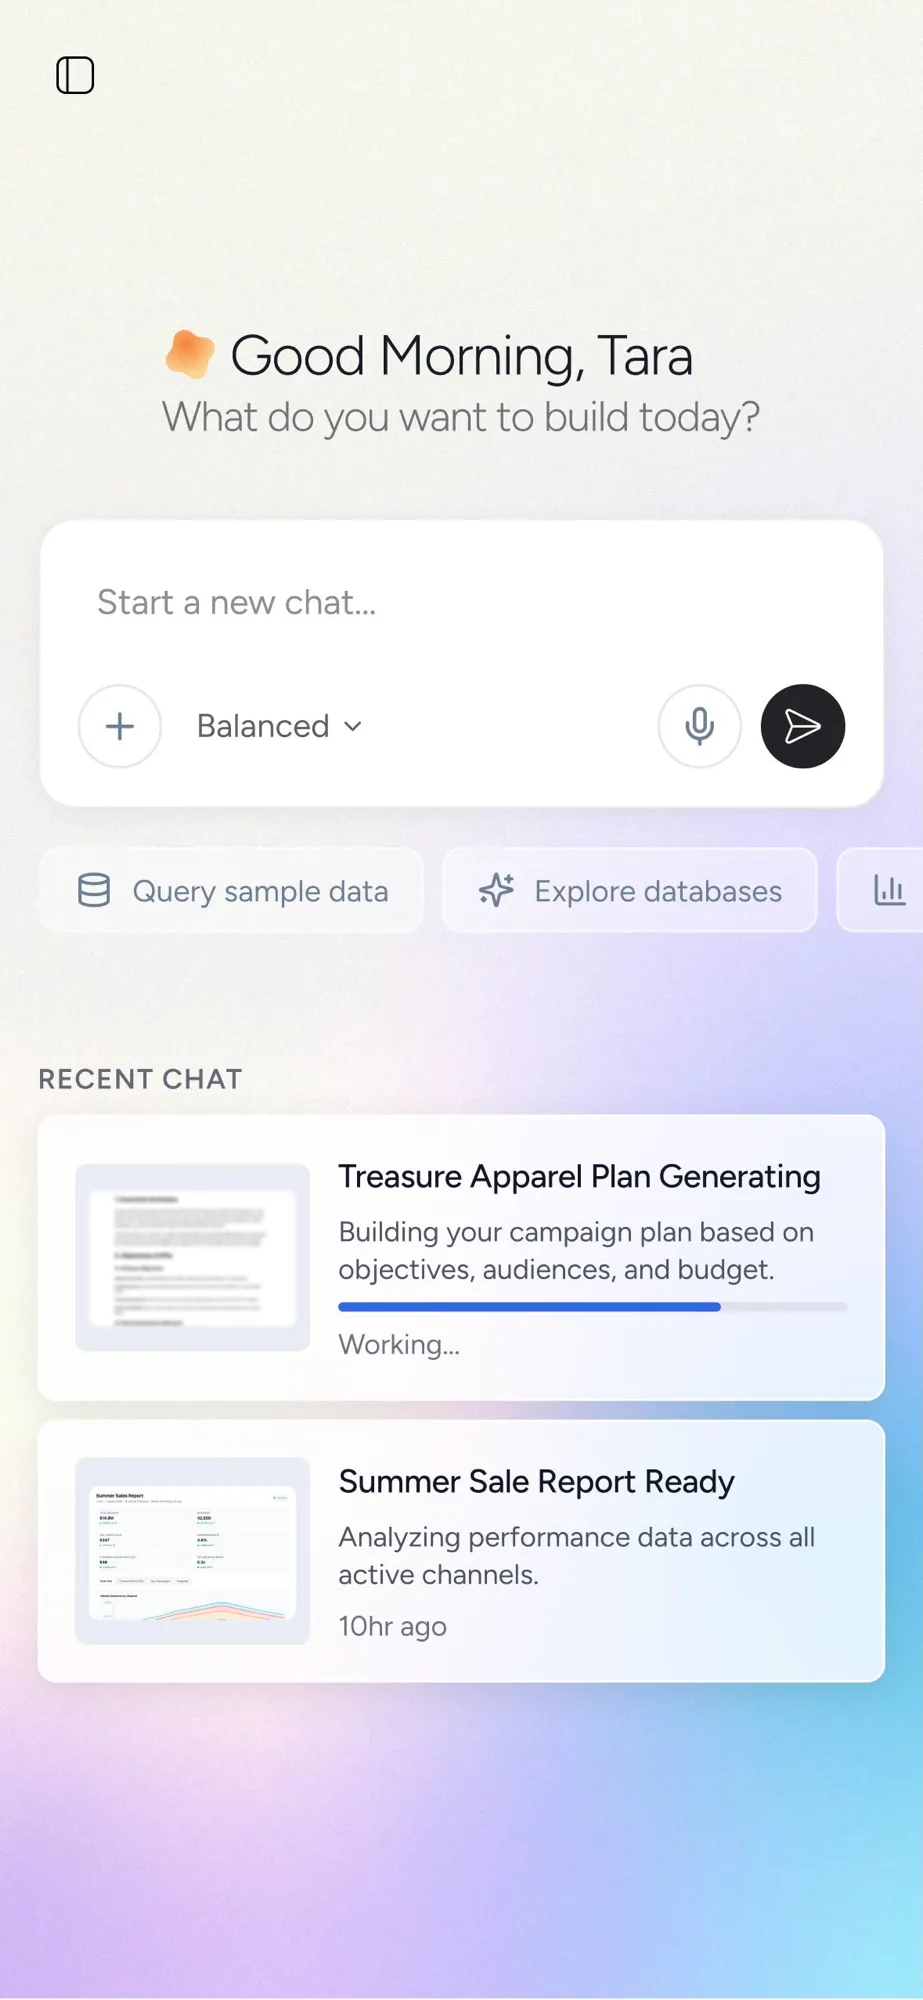
Treasure AI Studio sur mobile. La même interface conversationnelle sur iOS et Android, pour suivre les campagnes et valider les actions en déplacement.
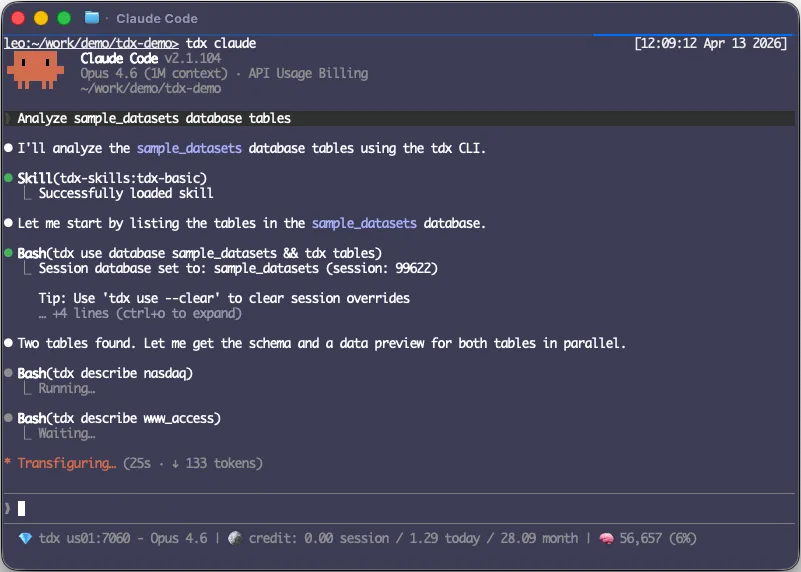
Treasure Code (CLI). Les équipes d’ingénierie travaillent avec Treasure AI depuis une interface en terminal construite sur Claude Code : inspection des schémas, exécution des requêtes et conduite des pipelines de données sans quitter la ligne de commande.
Messagerie omnicanale
La plateforme intègre des capacités de messagerie natives sur ces canaux :
- E-mail : contenu personnalisé, avec optimisation de l’heure d’envoi par l’IA (Email Marketing)
- SMS : messages transactionnels et promotionnels, avec liens courts propres à chaque destinataire et suivi natif des clics depuis septembre 2026 (SMS Marketing)
- Push mobile : notifications push iOS et Android (Mobile App Marketing)
- Message in-app : messages contextuels dans les applications mobiles
- LINE : intégration native à la messagerie LINE, déterminante pour les marchés d’Asie-Pacifique ; depuis août 2026, les messages des comptes officiels LINE (texte, Imagemap et Flex) peuvent aussi alimenter des campagnes continues, aux côtés de l’e-mail et du push
L’e-mail et le SMS, canaux de relation client dominants en France, figurent parmi ces canaux natifs ; LINE répond à un usage d’Asie-Pacifique sans équivalent sur le marché français.
Intégrer la messagerie plutôt que d’exiger une plateforme d’engagement client séparée fait revenir les résultats d’engagement (ouvertures, clics, conversions) directement dans le Customer Intelligence Loop, sans la latence d’un passage entre deux éditeurs.
Treasure Data (CDP) : la couche de contexte
Le socle de la plateforme est Treasure Data, la CDP qui sert de couche de contexte. Cette couche ingère les données clients, résout les identités, construit les profils unifiés et applique les politiques de gouvernance. Tous les produits décrits plus haut — Studio, Super Agents et messagerie — lisent et écrivent dans la couche de contexte.
Capacités centrales de la couche de contexte :
- Ingestion des données : plus de 170 connecteurs prêts à l’emploi pour l’ingestion par lots et en flux depuis le CRM, l’e-commerce, l’analyse web, le point de vente, le service client et les sources IoT
- Résolution d’identité : rapprochement déterministe et probabiliste par apprentissage automatique (machine learning), qui résout les identités entre appareils, canaux et comptes
- Profils unifiés : profils persistants de vision client 360° (Customer 360) qui regroupent les données comportementales, transactionnelles et démographiques dans un seul enregistrement
- Décision par l’IA et intelligence des modèles : analyse prédictive (predictive analytics), score d’appétence (propensity score) et traitement des signaux en temps réel, qui alimentent les étapes COMPRENDRE et DÉCIDER de la boucle
- Gouvernance des données : contrôle d’accès au niveau du champ, application du consentement et automatisation de la conformité sur toute l’activation en aval
C’est la couche marquée « Composable » sur le schéma d’architecture : l’entreprise la connecte au data warehouse qu’elle exploite déjà par le modèle de déploiement hybride, et les données restent dans le data warehouse pendant que la couche de contexte traite l’identité, l’IA et la gouvernance.
La couche de contexte fonctionne selon deux modes. Complete CDP est le déploiement entièrement managé : les données sont ingérées et stockées dans la plateforme, qui assure la résolution d’identité, la segmentation et l’activation sans data warehouse préalable. Avec Composable CDP (Composable Audience Studio), Treasure AI envoie des requêtes fédérées à Snowflake, BigQuery ou Databricks. Le data warehouse les exécute sur ses propres ressources de calcul et ne renvoie que les résultats, sans synchronisation par reverse ETL vers un second stockage. L’équipe marketing construit les audiences visuellement ; les tables sources restent dans le data warehouse, les résultats reviennent à Treasure AI et les données client n’atteignent une destination que lors de l’activation de l’audience. La plateforme propose aussi la résolution d’identité managée, la décision par l’IA et la messagerie native. Une entreprise qui la compare à une CDP composable telle que Hightouch doit vérifier quelles fonctions sont natives ou passent par des intégrations chez chaque éditeur, et dans quel mode de déploiement elles sont disponibles. Le guide comparatif des CDP détaille ces architectures.
Composable Audience Studio sur Snowflake, Databricks et BigQuery
En 2026, Composable Audience Studio a étendu la construction d’audiences dans le data warehouse : Snowflake et Databricks sont pris en charge depuis le 27 avril, BigQuery depuis le 11 mai (notes de version d’avril et de mai). Les versions suivantes traitent aussi du journal d’audit, du contrôle d’accès, de l’attribution des coûts de calcul et de la gestion par code :
| Date (2026) | Évolution | Conséquence pour l’équipe data |
|---|---|---|
| 27 avril | Composable Audience Studio sur Snowflake et Databricks | Segmentation, scoring prédictif et activation sur les tables du data warehouse, sans copie dans Treasure AI |
| 11 mai | Composable Audience Studio sur BigQuery | Segmentation et activation sur les tables Google BigQuery |
| 10 juin | Événements du journal d’audit Premium | Même couverture de journal d’audit que dans Audience Studio managé, y compris les refus d’autorisation |
| 30 juin | Autorisations fondées sur des politiques | Accès complet, limité ou refusé pour chaque segment parent composable et chaque dossier de segments |
| 24 juillet | Création et mise à jour par YAML avec tdx cas push | Audiences, attributs, comportements, segments et activations gérés par code, avec aperçu avant application des changements |
| 16 août | Open Catalog Access | Dans l’autre sens, tables de Complete CDP publiées en lecture seule au format Apache Iceberg, interrogeables sur place par Snowflake et Databricks (disponibilité générale) et BigQuery (expérimental) ; activation sur demande |
| 2 septembre | Balises de requête Snowflake | Un QUERY_TAG JSON sur les requêtes de segmentation, d’activation, de recherche de profils et les requêtes associées attribue les coûts de calcul à chaque audience, segment ou activation pour le suivi ou la refacturation interne |
Chaque data warehouse utilise son propre modèle d’authentification. Les trois partagent toutefois un modèle de données : un segment parent composable part d’une table de clients qui comporte une ligne par profil et un identifiant unique, reliée par une relation un-à-plusieurs à des tables de comportements dotées chacune d’une colonne temporelle (guide Snowflake).
| Data warehouse | Authentification | Prérequis retenus |
|---|---|---|
| Snowflake | Paire de clés | Un data warehouse pour exécuter les requêtes ; un utilisateur et un rôle avec le droit SELECT sur les tables visées |
| Databricks | Compte de service (service principal) avec OAuth | Unity Catalog activé ; un SQL warehouse ou un cluster de calcul |
| BigQuery | Compte de service GCP avec clé JSON | Droits de créer des comptes de service et de gérer les rôles IAM |
Ce mode rapproche Treasure AI des éditeurs de CDP composables comme Hightouch : les audiences sont construites sur les tables du data warehouse, sous ses contrôles d’accès. Les coûts et les responsabilités suivent cette architecture. La documentation de Composable CDP précise que les requêtes consomment les ressources de calcul du data warehouse du client et que l’équipe data doit concevoir et maintenir les schémas, puis régler les performances. L’absence de copie des données par lots s’arrête à l’activation : une audience envoyée à une plateforme publicitaire ou à un canal de messagerie quitte le data warehouse, comme avec les autres outils composables. Une équipe qui souhaite confier le stockage et la gestion des schémas à Treasure AI peut retenir Complete CDP.
Real-Time 2.0 : profils en temps réel et données en flux
Une cliente ajoute une veste à son panier, continue sa visite, puis quitte le site. Pendant la session, l’offre affichée peut tenir compte du panier et de l’historique d’achat ; après le départ, un déclencheur distinct peut lancer un message de relance. Real-Time 2.0 traite les deux cas en dirigeant chaque événement reçu simultanément vers un parcours en temps réel et un parcours par lots (présentation de Real-Time). Le moteur de décision traite l’événement en quelques millisecondes : il rapproche les identifiants, actualise les attributs en temps réel, dont les compteurs de session et la valeur du panier, puis combine l’événement au profil conservé par le traitement par lots. En parallèle, des workflows planifiés, généralement toutes les quelques minutes à quelques heures, agrègent l’historique, calculent les scores prédictifs et actualisent les liens entre identifiants. Lorsque le moteur en temps réel reçoit un événement, il lit le dernier profil issu du traitement par lots : la décision en cours de session tient compte de l’historique du client, pas seulement de sa visite.
Le rapprochement des identifiants s’effectue dans le flux. Si des événements portent des identifiants communs sur une clé configurée, le système les réunit dans un profil à leur arrivée, pour les identifiants connus comme anonymes. Un premier événement peut porter une adresse e-mail et un identifiant de cookie ; le suivant, le même cookie et un identifiant d’appareil (documentation sur le rapprochement d’identifiants). Le traitement par lots reste le système de référence pour l’historique des profils.
Treasure AI publie les limites de fonctionnement de la couche temps réel dans sa documentation sur les performances :
| Dimension | Chiffre publié |
|---|---|
| Réponse de l’API de personnalisation | ≤ 100 ms au p95 pour 20 attributs au maximum (SLA réservé aux clients disposant d’Enterprise Support) |
| Activations déclenchées | Jusqu’à 3 minutes de bout en bout, évaluation, rapprochement d’identifiants et envoi compris |
| Ingestion en flux | 2 000 événements par seconde et par client par défaut ; la plateforme peut atteindre plus de 100 000 événements par seconde à l’échelle mondiale, pas par client |
| Débit du moteur de décision | 8 000 événements par seconde et par client |
| Limites d’identité | Jusqu’à 100 clés de rapprochement d’identifiants et 200 identifiants par profil ; les plus anciens sont écartés en premier |
| Attributs en temps réel | Jusqu’à 200 par profil, de 500 octets chacun |
Deux versions de 2026 ont étendu cette couche. Le Lookup Catalog, ajouté le 17 juillet, croise les attributs du profil avec une table de référence externe au moment de la décision, par exemple pour choisir un produit, rappeler un coupon ou afficher une offre à durée limitée. Les tables de journal des identités en temps réel, ajoutées le 14 septembre, consignent les identifiants refusés pour le rapprochement, ceux écartés à la limite de 200 par profil et les identifiants entrants associés à chaque fusion. L’équipe data peut ainsi examiner comment les profils ont été réunis.
Les deux délais mesurent des opérations distinctes. La personnalisation sur le site dépend du temps de réponse de l’API, couvert par le SLA de ≤ 100 ms au p95 dans les conditions ci-dessus. Le message envoyé après un abandon emprunte la voie de l’activation déclenchée, dont le délai publié va jusqu’à 3 minutes. Un déploiement d’au moins 100 segments parents doit être testé en preuve de concept. Une équipe limitée aux campagnes hebdomadaires et aux rapports mensuels n’a pas nécessairement besoin de la voie temps réel.
Résultats de l’accès anticipé
Pendant l’accès anticipé de 2026, Treasure AI a publié deux résultats obtenus auprès de grands comptes :
- Retail grand compte : un client du retail a ramené de cinq jours à huit heures le passage de la création du segment au lancement de la campagne, avec les AI Super Agents. L’agent a repéré un segment à forte intention de 340 000 profils que l’analyse manuelle n’avait pas vu, et ce segment a produit une hausse de 23 % de la conversion.
- Services financiers : une équipe d’analyse de données a remplacé un cycle de rapports de trois jours par des requêtes en langage naturel de 60 secondes dans Treasure AI Studio, ce qui a libéré les analystes pour l’interprétation stratégique plutôt que pour l’extraction des données.
Ces deux résultats proviennent de l’éditeur et portent sur des déploiements en phase précoce. Aucune validation indépendante d’analyste ni référence client plus large n’existe encore pour ces deux cas.
Customer Intelligence Loop
Le Customer Intelligence Loop est un cycle continu en cinq étapes qui décrit le trajet des données clients, de la collecte à l’activation, et le retour des résultats d’engagement vers les décisions suivantes. La plupart des stacks marketing exécutent ce cycle par étapes déconnectées : un data warehouse collecte les données, un outil séparé résout les identités, un autre construit les segments et un dernier envoie les messages. Chaque passage de relais ajoute de la latence et perd du contexte. Le Customer Intelligence Loop est le principe selon lequel Treasure AI organise la plateforme pour combler ces lacunes : les cinq étapes s’exécutent dans une seule plateforme, et les agents IA parcourent la boucle en continu au lieu d’attendre un lot déclenché par une personne.
COLLECTER → UNIFIER → COMPRENDRE → DÉCIDER → ENGAGER → (retour à COLLECTER)
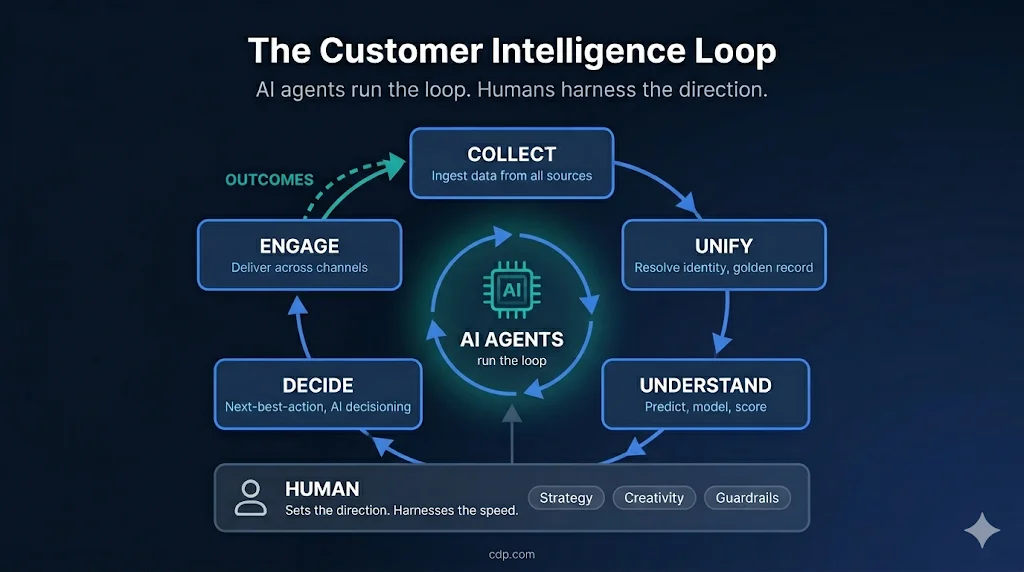
Chaque étape correspond à des capacités précises de la plateforme :
| Étape | Ce qui se passe | Capacité de la plateforme |
|---|---|---|
| COLLECTER | Ingérer les données de n’importe quelle source : comportement, transaction, CRM, service client, IoT | Plus de 170 connecteurs prêts à l’emploi, ingestion en flux et par lots |
| UNIFIER | Résoudre les identités entre appareils, canaux et comptes en profils unifiés | Résolution d’identité par apprentissage automatique, rapprochement déterministe et probabiliste |
| COMPRENDRE | Analyser le comportement client, prédire l’intention, calculer le score d’appétence | Analyse prédictive, modélisation de la valeur vie client (customer lifetime value), prédiction du churn |
| DÉCIDER | Déterminer la meilleure action suivante pour chaque client | Moteur de décision par l’IA, arbitrage des offres en temps réel |
| ENGAGER | Exécuter des expériences personnalisées sur tous les canaux | Messagerie omnicanale native, activation des données vers des systèmes externes |
Les résultats d’engagement (ouvertures d’e-mail, conversions d’achat, contacts avec le service client) reviennent à l’étape COLLECTER et ferment la boucle. Pour une organisation qui exécute des campagnes hebdomadaires par lots, sans exigence de personnalisation en temps réel ni en cours de session, la boucle continue n’est pas indispensable : une architecture composable qui parcourt la boucle chaque jour ou chaque semaine apporte une valeur suffisante avec moins de complexité.
Gouvernance et sécurité
La gouvernance des données est une exigence de base pour toute plateforme qui traite des données à caractère personnel (personally identifiable information, PII) à grande échelle. Les capacités de gouvernance de Treasure AI comprennent :
- Certifications de conformité : SOC 2 Type II, RGPD (GDPR), CCPA, éligibilité HIPAA
- Infrastructure : exécution sur AWS, avec intégration de Bedrock pour les charges de travail d’IA
- Journal d’audit : journalisation infalsifiable de chaque accès aux données, de chaque action d’agent et de chaque événement d’activation
- Gestion du consentement : application centralisée du consentement sur tous les canaux d’activation
- Résidence des données : options de stockage régional pour les organisations soumises à des exigences de localisation des données
- Instructions communes aux agents de l’organisation : les administrateurs peuvent définir jusqu’à 16 384 caractères d’instructions permanentes, ajoutées au prompt système de tous les agents AI Studio de l’organisation dans les nouvelles conversations. Elles orientent le comportement des agents ; l’accès aux données dépend toujours des contrôles techniques décrits ci-dessus, pas de ces instructions
- Politique de données pour l’IA : les données clients ne servent jamais à entraîner des modèles d’IA
Pour la liste complète des certifications et la documentation de sécurité, voir le Treasure AI Trust Center.
Un déploiement français relève de deux textes à la fois : le RGPD (règlement (UE) 2016/679) et la loi Informatique et Libertés (loi n° 78-17 du 6 janvier 1978, modifiée), dont l’autorité de contrôle est la CNIL (Commission nationale de l’informatique et des libertés) ; la CCPA reste la référence américaine. La liste des certifications couvre ce couple européen et américain, pas le paramétrage attendu par les lignes directrices et la recommandation de la CNIL sur les cookies et autres traceurs (délibérations n° 2020-091 et n° 2020-092 du 17 septembre 2020). L’entreprise a intérêt à demander à l’éditeur comment le recueil du consentement, la durée de conservation des traceurs et la région de stockage sont réglés dans le contrat, et à faire valider la cartographie des traitements par le DPO (délégué à la protection des données) avant la mise en production. Les textes eux-mêmes sont détaillés dans le glossaire des réglementations sur la protection des données et dans le guide des lois françaises et américaines sur la protection des données.
Le journal d’audit infalsifiable compte surtout dans les secteurs régulés : les organisations de services financiers et de santé doivent prouver qui, ou quel agent, a consulté les données clients et quelles actions ont été exécutées.
À quelles organisations Treasure AI convient-elle ?
Treasure AI convient d’abord aux organisations qui :
- Ont besoin du Customer Intelligence Loop complet dans une seule plateforme : ingestion des données, résolution d’identité, décision par l’IA et activation sans enchaîner plusieurs éditeurs
- Souhaitent des agents IA qui travaillent sur des données clients unifiées : pas seulement des tableaux de bord pour les équipes, mais une architecture centrée sur les agents où l’IA exécute en continu
- Exigent une gouvernance de niveau grand compte : conformité SOC 2, RGPD, CCPA et HIPAA, avec des actions d’agent auditables
- Travaillent sur plusieurs canaux : e-mail, SMS, push, message in-app, LINE, personnalisation web et activation des médias payants
- Ont déjà investi dans un data warehouse : Composable Audience Studio construit et active les audiences directement sur les tables Snowflake, Databricks et BigQuery ; les agents AI Studio peuvent aussi interroger Snowflake et Databricks pendant une conversation
- Servent les marchés d’Asie-Pacifique : intégration native à LINE et options de résidence régionale des données
Organisations pour lesquelles une autre architecture convient mieux :
- Les équipes qui n’ont besoin que de reverse ETL : une organisation dotée d’un data warehouse mature, dont la logique de segmentation est déjà écrite en SQL et qui n’a besoin ni de résolution d’identité, ni de décision par l’IA, ni de messagerie native se contente souvent d’un outil de reverse ETL isolé. L’architecture hybride de Treasure AI se connecte aux mêmes data warehouses, mais la plateforme complète dépasse alors le besoin
- Les organisations entièrement engagées dans une seule suite (Adobe ou Salesforce) trouvent une intégration plus étroite dans cet écosystème, malgré les compromis du surcoût de la suite. Qui exploite Salesforce et Adobe en même temps, ou mélange des produits de suite et des outils spécialisés, doit décider si l’unification des données se fait dans la CDP de l’une des deux suites ou dans une plateforme indépendante des deux
- Les petites entreprises aux besoins de données simples (moins de 100 000 profils, un ou deux canaux) n’ont pas l’usage des capacités destinées aux grands comptes
Les critères d’évaluation à appliquer à cette plateforme comme aux autres sont détaillés dans le guide d’évaluation d’une CDP.
FAQ
Qu’est devenu Treasure Data ?
Treasure Data a changé de marque pour devenir Treasure AI le 20 avril 2026. Le domaine de l’entreprise est passé de treasuredata.com à treasure.ai, et le produit a évolué d’une plateforme de données client vers une plateforme d’expérience agentique. Les intégrations, les API et les SDK des clients existants restent rétrocompatibles : le changement de marque traduit une évolution de produit, pas une rupture de compatibilité.
Treasure AI est-elle une CDP ou autre chose ?
Treasure AI contient une CDP complète — ingestion des données, résolution d’identité, segmentation, activation — et y ajoute la messagerie native et des capacités d’agent IA. L’étiquette « plateforme d’expérience agentique » traduit l’ajout de la décision et de l’exécution par l’IA au-dessus de ce socle. Qui évalue Treasure AI face à d’autres CDP compare le périmètre complet de la plateforme, pas seulement la couche d’unification des données.
En quoi Treasure AI diffère-t-elle des autres CDP ?
Treasure AI réunit la CDP, la messagerie omnicanale et les agents IA dans une seule plateforme qui exécute le Customer Intelligence Loop en continu. La plupart des CDP traitent l’unification et la segmentation, mais exigent des outils séparés pour la messagerie et la décision par l’IA, soit quatre à cinq éditeurs dans une stack composable. Treasure AI garde les cinq étapes de la boucle dans une seule plateforme, ce qui évite la duplication de données personnelles propre au reverse ETL.
Treasure AI est-elle la bonne CDP pour mon organisation ?
Treasure AI est la bonne CDP pour les groupes internationaux et multimarques, B2C comme B2B, aux volumes de données importants et aux besoins de couverture Asie-Pacifique, et le mauvais choix pour une petite équipe ou une équipe marketing en libre-service. L’entreprise a intérêt à retenir Treasure AI pour le périmètre couvert par une seule plateforme (déploiement packagé ou composable, IA prédictive et agentique native, e-mail, SMS et push natifs), et à l’écarter si l’équipe marketing cherche la simplicité d’un outil en libre-service ou si le budget est celui d’une PME.
Quelles sont les alternatives à Treasure AI en France ?
Adobe Real-Time CDP, Salesforce Data Cloud et Hightouch sont les alternatives que ce site couvre pour le marché français, aux côtés des éditeurs français imagino et DinMo. Adobe Real-Time CDP convient aux organisations qui exploitent déjà Adobe Experience Cloud ; Salesforce Data Cloud, à celles dont Sales Cloud ou Service Cloud est le système de référence ; Hightouch, aux équipes data qui activent un data warehouse déjà modélisé. cdp.com ne publie pas encore de profil d’imagino ni de DinMo.
Treasure AI est-elle une CDP en temps réel ?
Oui : Real-Time 2.0 traite les événements en flux en quelques millisecondes, rapproche les identifiants à leur arrivée et publie un SLA pour l’API de personnalisation de ≤ 100 ms au p95 pour 20 attributs au maximum, réservé aux clients disposant d’Enterprise Support. Les activations déclenchées sont envoyées en 3 minutes au maximum. Le traitement par lots calcule les scores prédictifs et actualise les liens entre identifiants selon une cadence planifiée. Le moteur temps réel lit le profil issu du traitement par lots à chaque événement : la décision en direct tient donc compte de l’historique du client.
Treasure AI fonctionne-t-elle avec Snowflake, Databricks et BigQuery ?
Oui : Composable Audience Studio construit et active les audiences sur les tables Snowflake, Databricks et BigQuery sans copier les données sources dans Treasure AI. Les requêtes consomment les ressources de calcul du data warehouse du client ; l’équipe data gère les schémas, et les données de l’audience quittent le data warehouse lors de l’activation vers une destination. Les agents AI Studio peuvent aussi interroger Snowflake et Databricks pendant une conversation, au moyen de connexions OAuth autorisées individuellement.
→ Comparez les éditeurs de CDP dans le guide comparatif
Le classement des éditeurs de CDP par les analystes → IDC MarketScape | Forrester Wave
Cet article est aussi disponible en : What Is Treasure AI (Formerly Treasure Data)? · Treasure AI(旧Treasure Data)とは?特徴と沿革 · O que é Treasure AI (ex-Treasure Data)? · ¿Qué es Treasure AI (antes Treasure Data)? · Treasure AI: CDP-Profil für Deutschland