Treasure AI (ehemals Treasure Data) ist eine Agentic Experience Platform (agentische Experience-Plattform) und damit eine Weiterentwicklung der klassischen Customer Data Platform (CDP) (auf Deutsch Kundendatenplattform): Sie bündelt Datenerfassung, Identitätsauflösung (identity resolution), CDP und Messaging in einer Plattform und lässt KI-Agenten (AI agents) Aufgaben in Personalisierung, Messaging und Entscheidungsfindung ausführen, während Menschen Strategie, Kreativität und Leitplanken beisteuern. Das Unternehmen startete 2011 als Datenmanagement-Plattform in Kalifornien und wandelte sich am 20. April 2026 zu Treasure AI um; die Produktkategorie wechselte von „Customer Data Platform“ zu „Agentic Experience Platform“.
Diese Seite beschreibt Treasure AI aus der Dokumentation des Anbieters, den Analystenberichten und der Geschichte des Unternehmens. Sie folgt denselben redaktionellen Regeln wie die Profile für Adobe Real-Time CDP, Salesforce Data Cloud und Tealium (auf Englisch).
Transparenz: cdp.com wird von Treasure AI betrieben, dem Unternehmen, das bis April 2026 Treasure Data hieß. Diese Regeln stehen in der Redaktionsrichtlinie (auf Englisch); sie gelten für alle sechs verglichenen Anbieter gleichermaßen.
Treasure AI in Stichpunkten
| Dimension | Treasure AI |
|---|---|
| Geeignet für | internationale Mehrmarkenunternehmen, die große Datenbestände über Regionen hinweg verwalten und KI sowie Messaging aus einer Plattform benötigen |
| Typische Käufergröße | Mittelstand und Großunternehmen; laut G2-Auswertung entfallen von den 163 Bewertungen mit Größenangabe rund 40 % auf Organisationen mit mehr als 1.000 Beschäftigten, 37 % auf 51 bis 1.000 und 23 % auf 50 oder weniger |
| Preismodell | Abrechnung je Profil und je Ereignis auf Anfrage; im Complete-CDP-Modus keine gesonderten Rechenkosten für Abfragen und Segmentierung, im Composable-Modus laufen Abfragen auf Rechenkapazität des eigenen Data Warehouse und werden dort abgerechnet |
| Typische Einführung | 4 bis 8 Wochen für die erste Phase; 3 bis 6 Monate für den vollständigen Rollout |
| Hauptunterschied | die breiteste Abdeckung unter den Package-Anbietern: Packaged oder Composable, dazu native KI und native Nachrichten in E-Mail, SMS und Push in einem Plattformrahmen |
| Weniger geeignet, wenn | das Marketingteam ein Werkzeug zur Selbstbedienung sucht oder das Budget einem Mittelstandsprojekt entspricht |
Die G2-Zahlen beschreiben, wer den Anbieter bewertet, nicht wer ihn einsetzt: Rezensenten wählen sich selbst aus, und Anbieter fahren Kampagnen zur Gewinnung von Rezensionen. Lesen Sie den Hinweis als Herkunftsangabe, nicht als Kundenzensus; die nach Unternehmensgröße klassifizierte Teilmenge ist kleiner als die Gesamtzahl der Bewertungen, auf die die Profilseite verweist. Den Vergleich mit den anderen fünf Anbietern für Deutschland führt die Seite Die besten CDP-Anbieter in Deutschland 2026; dort steht auch, warum kein Profil dieser Klasse einen Kunden beim Namen nennt.
Die Geschichte des Unternehmens
Treasure Data wurde 2011 in Mountain View im US-Bundesstaat Kalifornien gegründet, zunächst als cloudbasierte Plattform für die Verwaltung von Logdaten und die Analyse großer Datenmengen. In den folgenden Jahren verschob das Unternehmen den Schwerpunkt auf Kundendaten und baute die Infrastruktur für Datenerfassung, Identitätsauflösung und Datenaktivierung aus; daraus wurde die Customer Data Platform des Anbieters.
Die Etappen:
| Jahr | Schritt |
|---|---|
| 2011 | Gründung in Mountain View als Plattform für Big-Data-Analysen |
| 2013 | Ausbau Richtung Enterprise-Kundenmanagement |
| 2018 | Übernahme durch Arm Holdings (SoftBank Group) für rund 600 Millionen US-Dollar |
| 2020 | Einstufung als Leader im Forrester Wave für Customer Analytics Technologies |
| 2022 | Strong Performer im Forrester-Wave-Bericht für CDPs |
| 2024 | Leader im Forrester-Wave-Bericht für CDPs, anerkannt für Datenfundament und Enterprise-Skalierung |
| 2026 | Umbenennung von Treasure Data in Treasure AI; Start der Agentic Experience Platform |
| 2026 | Leader im IDC MarketScape für KI-gestützte Customer Data Platforms für B2C-Nutzer (Dokument #US53952526); dazu Leader im B2B-Pendant (Dokument #US53952326), eine Doppel-Einstufung, die auch Salesforce erreicht |
Für 2026 verweist Treasure AI selbst auf mehr als 400 Großkunden aus Handel, Finanzdienstleistung, Gesundheitswesen, Automotive, Konsumgütern und Medien und nennt mehrere Milliarden vereinheitlichter Kundenprofile – eine Herstellerangabe, die keine unabhängige Prüfung durchlaufen hat.
Die Umbenennung: von Treasure Data zu Treasure AI
Am 20. April 2026 trat die Umbenennung in Kraft. Die Domain wechselte von treasuredata.com zu treasure.ai, die Produktkategorie von „Customer Data Platform“ zu „Agentic Experience Platform“.
Die Umbenennung spiegelt eine strukturelle Verschiebung. Treasure Data begann als System, in dem Menschen auf vereinheitlichte Kundendaten zugriffen, um Marketingentscheidungen zu treffen. Treasure AI ist so gebaut, dass KI-Agenten auf denselben Daten entscheiden und ausführen – die Menschen liefern Strategie, Kreativität und Leitplanken.
Drei Änderungen markieren den Übergang:
-
Von der Datenplattform zur Experience-Plattform. Die erste Generation erfasste und vereinheitlichte Kundendaten und aktivierte Zielgruppen nach außen. Die neue Plattform fügt natives omnichannel-Messaging in E-Mail, SMS, Push und In-App, Entscheidung durch die KI (AI decisioning) und Personalisierung in Echtzeit hinzu. Dadurch läuft der Customer Intelligence Loop in einem System, statt die Stufen auf getrennte Anbieter zu verteilen.
-
Von der menschzentrierten zur agentenzentrierten Architektur. Die Hauptoberfläche wechselt von Dashboards und Abfragewerkzeugen zu KI-Agenten, die über MCP (Model Context Protocol), Kommandozeile, APIs und vorgefertigte Agentenfähigkeiten arbeiten. Menschen steuern die Strategie; die Agenten übernehmen die Ausführung im großen Maßstab.
-
Vom Stapelzyklus zur fortlaufenden Schleife. Wo die frühere CDP die Kundensegmentierung in Stapeln lief, täglich oder wöchentlich, läuft der Customer Intelligence Loop kontinuierlich: ERFASSEN, VEREINHEITLICHEN, VERSTEHEN, ENTSCHEIDEN und ANSPRECHEN in Minuten, wobei das Ergebnis jeder Interaktion in den nächsten Zyklus zurückfließt.
Bisherige APIs, SDKs und Arbeitsabläufe laufen unverändert weiter. Die Umbenennung ist eine Produktenwicklung, keine Migration, die bestehende Integrationen bricht.
Die Architektur der Plattform
Die Architektur trennt die Steuerungsebene (control plane) von der Datenebene (data plane):
-
Steuerungsebene (Treasure AI): Identitätsauflösung, Zielgruppensegmentierung, KI-Entscheidung, Messaging-Orchestrierung und die Laufzeitumgebung der Agenten. Auf dieser verwalteten Schicht läuft der Customer Intelligence Loop.
-
Datenebene (Infrastruktur des Kunden): Kundendaten können im eigenen Data Warehouse liegen: in Snowflake, Databricks oder BigQuery. Treasure AI fragt die Tabellen am Speicherort ab, ohne eine Kopie in einen proprietären Speicher zu verlangen. Umgekehrt kann das Data Warehouse Tabellen abfragen, die Treasure AI verwaltet und als schreibgeschützte Apache-Iceberg-Tabellen veröffentlicht – ohne zweite Kopie.
Das hybride Betriebsmodell verbindet Abfragen auf Warehouse-Tabellen mit einer verwalteten Steuerungsebene für schnellen Profilzugriff und Aktivierung in Echtzeit. Im Vergleich mit Composable CDPs zählt, welche Funktionen für Profilzugriff und KI-Entscheidung ein Anbieter nativ oder über Integrationen bereitstellt. Bei Packaged CDPs liegen die Profile dagegen im verwalteten Speicher der jeweiligen Plattform.
Die Komponenten der Plattform
Treasure AI Studio
Das Studio ist die Hauptoberfläche und läuft auf mehreren Wegen: im Browser für Marketing-, Analyse- und Datenteams, als Desktop-Anwendung für macOS und Windows, als mobile App für iOS und Android zur Überwachung und Freigabe unterwegs, als Kommandozeilenschnittstelle Treasure Code für Ingenieure und als Sprachschnittstelle Treasure AI Voice. Die Kommandozeilenschnittstelle Treasure Code baut auf Claude Code auf und deckt Schemaprüfung, Abfragen und Pipeline-Betrieb im Terminal ab.
Das Studio bietet den Zugang zu den Kundendaten, zur Segmentierung, zur Kampagnenverwaltung und zur Analyse in natürlicher Sprache; ein nichttechnisches Team kann Abfragen stellen und Aktionen auslösen, ohne SQL zu schreiben oder den Support der Datentechnik zu bemühen.
Über AI Studio Connections greifen die KI-Agenten auch auf Daten außerhalb von Treasure AI zu. Seit Juni 2026 können sie in einem Gespräch Daten in einem Snowflake-Data-Warehouse (seit 25. Juni) oder einem Databricks-Lakehouse (seit 17. Juni) untersuchen und visualisieren. Seit dem 14. Juli lassen sich über das gleiche Verbindungsmodell auch CDP-Abfragen, Workflows und Zielgruppensegmente in Treasure Data steuern. Ein Administrator registriert jeden Konnektor einmal je Organisation über OAuth; anschließend autorisiert jeder Nutzer seine Verbindung. Der Agent erhält nur ein Platzhalter-Token, das erst an der Netzwerkgrenze durch die tatsächlichen Zugangsdaten ersetzt wird (Release Note vom Juni 2026). Der Agent sieht nur Daten, auf die die autorisierte Warehouse-Rolle zugreifen darf. Der Snowflake-Konnektor des AI Studio verwendet dafür die Rolle PUBLIC: Eine für den Agenten freigegebene Tabelle ist damit auch für alle anderen Snowflake-Nutzer sichtbar. Das Datenteam muss die Freigaben entsprechend begrenzen. Composable Audience Studio nutzt gesondert konfigurierte Snowflake-Zugangsdaten.
Arbeitsordner speichern den Kontext über einzelne Chats hinaus. Jeder Ordner enthält eine Anweisungsdatei, die die KI zu Beginn jedes Gesprächs liest und während der Arbeit aktualisieren kann; Tabellennamen, Konventionen und Ziele bleiben so erhalten (Dokumentation zum sitzungsübergreifenden Gedächtnis). Seit dem 17. September 2026 lässt sich ein Arbeitsordner für ein ganzes Konto freigeben. Die Mitglieder sehen denselben Dateibaum mit Anweisungen, Referenzdateien, Fähigkeiten und gespeicherten Aktionen, arbeiten aber jeweils mit dem eigenen KI-Agenten. Hat ein Marketingteam im Ordner festgelegt, welche Tabellen und Segmente für den wöchentlichen Kampagnenbericht zählen, kann ein anderes Teammitglied auf dieser Grundlage weiterarbeiten. Änderungen, die der eigene Agent mit entsprechender Berechtigung in den Ordner schreibt, stehen im nächsten Gespräch zur Verfügung.
Die Freigabe eines Arbeitsordners öffnet nicht die privaten Chats oder das persönliche Verzeichnis my/ der Mitglieder. Arbeitsmodi regeln auf Dateisystemebene, wo ein Agent in den gemeinsam genutzten Dateien schreiben darf: nirgends, nur in benannten Ordnern der obersten Ebene oder überall. Über den Zugriff auf den Ordner entscheiden dessen Verwalter. Selbst ein Kontoadministrator ohne Arbeitsmodus für den Ordner kann dessen Inhalt nicht lesen (Zugriffskontrolle).
Auch wiederkehrende Arbeit lässt sich aus dem Arbeitsordner starten. Work Folder Actions speichern seit dem 13. August 2026 einen Ablauf zur erneuten Ausführung; Action Schedules starten solche Abläufe seit dem 25. August täglich, an Werktagen, wöchentlich, monatlich oder nach einem eigenen Cron-Plan, ohne dass jemand auf „Run“ klickt (Release Note vom August 2026). Ein Zeitplan löst jedoch nicht bei einem Kundenereignis aus: Für unmittelbare Reaktionen auf Verhalten bleibt die Echtzeitschicht zuständig.
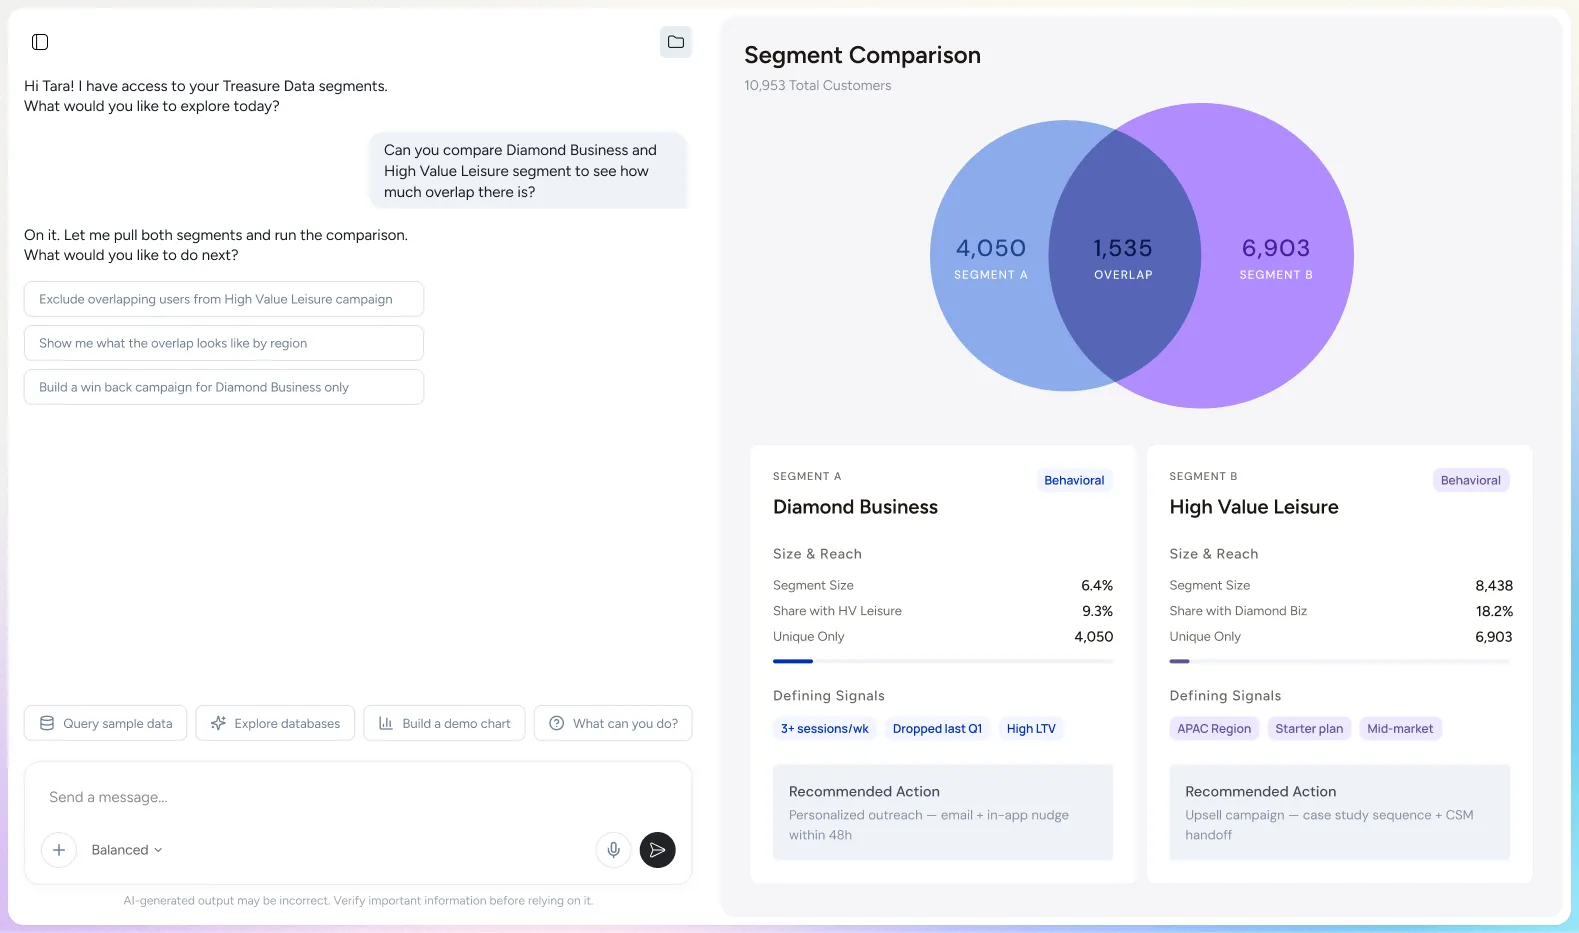
Segmentvergleich in Treasure AI Studio: Die Frage in natürlicher Sprache löst die Überlappungsanalyse zweier Zielgruppen aus und nennt empfohlene nächste Aktionen, ohne dass ein Team SQL oder BI-Werkzeuge bedient.
Die KI-Supervisor-Agenten
Die Plattform liefert zwei vorgefertigte, domänenspezifische Agenten mit, die Arbeitsschritte innerhalb des Customer Intelligence Loop automatisieren:
Der Supervisor-Agent für das Marketing: Kampagnen aus eigenem Antrieb
Die Rolle deckt Entdeckung von Zielgruppen, Kampagnenerstellung, Next Best Action (nächstbeste Aktion) und Aktivierung über die endverbraucherorientierten Kanäle ab. Für eine Rückgewinnungsaktion beschreibt das Marketingteam das Ziel – Kunden, die im ersten Quartal gekauft haben und seit 60 Tagen nicht interagiert haben – und der Agent baut daraus das Segment, wählt die Kanäle und startet die Kampagne.
Der Supervisor-Agent für die Datenanalyse: Berichte aus eigener Bewegung
Der Agent automatisiert Datenexploration, Erkenntnisgewinnung und Berichtserstellung. Das Analyseteam fragt in einfacher Sprache und erhält strukturierte Antworten mit Datenvisualisierungen. In der frühen Zugangsversion berichtete ein Team im Finanzwesen, dass die Bearbeitungszeit für Routineanfragen von drei Tagen auf 60 Sekunden sank.
Beide Agenten arbeiten auf der vereinheitlichten Datenbasis der Plattform: Sie lesen vollständige, aufgelöste Kundenprofile, keine Fragmente aus getrennten Systemen. Die Ergebnisse stammen aus der Frühphase; eine unabhängige Prüfung durch Dritte fehlt.
Natives Messaging über Kanäle hinweg
Die Plattform versendet über vier nativ gebundene Kanäle: E-Mail mit KI-geregelter Versandzeit, SMS für transaktionale und werbliche Nachrichten, seit September 2026 mit eigenen Kurzlinks je Empfänger und integrierter Erfassung der Klicks, Push-Nachrichten auf iOS und Android und In-App-Nachrichten innerhalb der mobilen Anwendungen. Für asiatisch-pazifische Märkte kommt eine native LINE-Anbindung hinzu – in Deutschland ohne Bedeutung. Seit August 2026 können Unternehmen Nachrichten über LINE Official Accounts als dauerhaft laufende Kampagnen neben E-Mail und Push versenden, auch als Text, Imagemap oder Flex Message.
Die Bündelung des Nachrichtenversands in einem System statt über ein getrenntes Customer-Engagement-Werkzeug hat einen konkreten Vorteil: Die Ergebnisse der Interaktion (Öffnungen, Klicks, Conversions) fließen ohne Latenzen zwischen Anbietern direkt in den Customer Intelligence Loop zurück. Beachten Sie dabei den Datenschutz: Eine Messaging-Schicht in derselben Plattform vermeidet die Kopie personenbezogener Daten an ein externes Versandsystem, und die Plattform trägt die Einwilligung als Regel in jeden Kanal.
Die CDP als Kontextschicht
Die Grundlage der Plattform ist die CDP selbst, die Kontextschicht. Hier fließen die Daten hinein, hier läuft die Identitätsauflösung, hier entstehen die einheitlichen Kundenprofile, und hier greifen die Datenschutz- und Zugriffsregeln. Studio, Agenten und Messaging lesen und schreiben auf dieser Schicht.
Die Fähigkeiten der Kontextschicht
- Datenerfassung – über 170 vorgefertigte Konnektoren für den Betrieb in Stapeln oder im Datenstrom, aus CRM, Onlineshop, Webanalyse, Kassensystemen, Support und IoT-Quellen
- Identitätsauflösung – zuordnendes Matching durch maschinelles Lernen, kombiniert aus deterministischer und probabilistischer Abstimmung über Geräte, Kanäle und Konten hinweg
- Einheitliche Kundenprofile – dauerhafte Customer-360-Profile, die Verhaltens-, Transaktions- und Stammdaten in einem Datensatz zusammenführen
- KI-Entscheidung und Modellintelligenz – Predictive Analytics, Neigungswerte und Echtzeitprozesse, die die Phasen VERSTEHEN und ENTSCHEIDEN des Loops tragen
- Daten-Governance – Feldzugriffe, Durchsetzung der Einwilligung und Konformitätsautomatisierung auf jedem Weg nach außen
Diese Schicht trägt im Architekturdiagramm die Bezeichnung „Composable“: Das Unternehmen verbindet sie mit seinem Data Warehouse und hält die Daten dort, während die Kontextschicht Identität, KI und Governance übernimmt.
Die Kontextschicht läuft in zwei Betriebsformen. Im Complete-CDP-Modus erfasst und speichert Treasure AI die Daten in der verwalteten Plattform. Konnektoren, Identitätsauflösung, Segmentierung und Aktivierung funktionieren dort auch ohne bestehendes Data Warehouse. Im Composable-CDP-Modus (Composable Audience Studio) sendet Treasure AI föderierte Abfragen an Snowflake, BigQuery oder Databricks. Das Data Warehouse führt sie auf eigener Rechenkapazität aus und liefert nur die Ergebnisse zurück; ein Abgleich per Reverse ETL in einen zweiten Datenspeicher entfällt. Das Marketingteam baut Zielgruppen visuell auf den Tabellen des Data Warehouse auf. Abfrageergebnisse gelangen zu Treasure AI, und bei der Aktivierung können Kundendaten an das gewählte Ziel übertragen werden. Beide Betriebsformen gehören zu einer Plattform mit verwalteter Identitätsauflösung, KI-Entscheidung und nativem Messaging. Beim Vergleich mit anderen Composable-CDP-Anbietern zählt, welche dieser Funktionen jeweils nativ oder über Integrationen verfügbar sind und für welche Betriebsform sie gelten. Einen Vergleich bietet die Übersicht der CDP-Anbieter.
Composable Audience Studio mit Snowflake, Databricks und BigQuery
Im Jahr 2026 wurde der Composable-Modus auf drei Data Warehouses ausgeweitet: Seit dem 27. April 2026 ist Composable Audience Studio für Snowflake und Databricks verfügbar, seit dem 11. Mai auch für BigQuery (Release Notes vom April und Mai). Die späteren Änderungen betreffen Fragen der Datentechnik und der Sicherheit: Wer darf welche Segmente bearbeiten, wie werden Abfragen geprüft und wem fallen die Warehouse-Kosten zu?
| Datum (2026) | Veröffentlichung | Bedeutung für das Datenteam |
|---|---|---|
| 27. April | Composable Audience Studio für Snowflake und Databricks | Segmentierung, prädiktive Bewertung und Aktivierung auf Warehouse-Tabellen ohne Kopie in Treasure AI |
| 11. Mai | Composable Audience Studio für BigQuery | Segmentierung und Aktivierung auf Tabellen in Google BigQuery |
| 10. Juni | Erweiterte Audit-Log-Ereignisse | Vollständige Gleichstellung des Prüfprotokolls mit dem verwalteten Audience Studio, einschließlich abgewiesener Zugriffe |
| 30. Juni | Richtlinienbasierte Berechtigungen | Voller, eingeschränkter oder kein Zugriff je übergeordnetem Composable-Segment und Segmentordner |
| 24. Juli | Erstellen und Aktualisieren per YAML mit tdx cas push | Zielgruppen, Attribute, Verhaltensdaten, Segmente und Aktivierungen als Code verwalten, mit Vorschau vor dem Anwenden |
| 16. August | Open Catalog Access | Umgekehrter Zugriff: Das Data Warehouse fragt schreibgeschützte Apache-Iceberg-Tabellen des Complete-CDP-Modus am Speicherort ab; Snowflake und Databricks allgemein verfügbar, BigQuery experimentell, Freischaltung auf Anfrage |
| 2. September | Snowflake-Abfragetags | Ein JSON-QUERY_TAG an Abfragen für Segmentierung, Aktivierung, Profilsuche und weitere Aufgaben ordnet Rechenkosten einzelnen Zielgruppen, Segmenten und Aktivierungen zu |
Jedes Data Warehouse hat ein eigenes Verfahren für die Zugangsdaten. Das Datenmodell ist gleich: Ein übergeordnetes Composable-Segment beruht auf einer Kundentabelle mit genau einer Zeile und einer eindeutigen Kennung je Profil. Daran hängen Verhaltenstabellen im Verhältnis eins zu viele, jeweils mit einer Zeitspalte (Snowflake-Einrichtung).
| Data Warehouse | Authentifizierung | Ausgewählte Voraussetzungen |
|---|---|---|
| Snowflake | Schlüsselpaar | Rechenkapazität für Abfragen; Nutzer und Rolle mit SELECT-Recht auf die benötigten Tabellen |
| Databricks | Dienstprinzipal mit OAuth | Aktivierter Unity Catalog; SQL-Warehouse oder Rechencluster |
| BigQuery | GCP-Dienstkonto mit JSON-Schlüssel | Berechtigung zum Erstellen von Dienstkonten und Verwalten von IAM-Rollen |
Im Composable-Modus bleiben die Quelltabellen im Data Warehouse; das unterscheidet die Architektur vom verwalteten Speicher des Complete-CDP-Modus. Die Dokumentation zum Composable-Modus nennt aber variable Kosten für Abfragen auf der Rechenkapazität des Kunden. Dessen Datenteam entwirft und pflegt auch die Schemata und stimmt die Leistung der Abfragen ab. „Ohne Kopie“ gilt für die Stapeldaten bis zur Aktivierung: Eine Zielgruppe, die an eine Werbeplattform oder einen Nachrichtenkanal gesendet wird, verlässt das Data Warehouse. Wer Speicher und Datenmodell von Treasure AI betreiben lassen möchte, wählt stattdessen den Complete-CDP-Modus.
Real-Time 2.0: Echtzeitprofile und Streaming-Daten
Ein Kunde legt eine Jacke in den Warenkorb und verlässt später den Onlineshop. Während der Sitzung kann ein Angebot den aktuellen Warenkorb und frühere Käufe berücksichtigen; danach kann eine getrennte Auslösung eine Nachricht starten. Die Echtzeitschicht Real-Time 2.0 verarbeitet dazu jedes eingehende Ereignis parallel auf zwei Wegen. Die Echtzeit-Engine löst Identitäten im Datenstrom auf, aktualisiert Merkmale wie den Sitzungszähler und den Warenkorbwert und verknüpft das Ereignis mit dem gespeicherten Profil aus der Stapelverarbeitung. Ihre Entscheidung über das Ereignis fällt in Millisekunden. Der zweite Weg nutzt geplante Abläufe, typischerweise im Abstand von einigen Minuten bis Stunden, um Ereignisverläufe auszuwerten, Prognosewerte zu berechnen und Identitätsbeziehungen zu aktualisieren. Beim Eintreffen eines Ereignisses liest die Echtzeit-Engine das aktuelle gespeicherte Profil: Die Entscheidung stützt sich damit auch auf die bisherige Kundenhistorie.
Die Zuordnung der Kennungen geschieht bereits im Datenstrom. Enthält ein Ereignis zum Beispiel E-Mail-Adresse und Cookie-ID und das nächste dieselbe Cookie-ID mit einer Geräte-ID, führt die Plattform diese Kennungen über einen konfigurierten Schlüssel zusammen. Das gilt auch für die Verbindung bekannter und anonymer Kennungen (Dokumentation zum ID-Stitching). Für historische Profile bleibt die Stapelschicht die führende Datenquelle.
Treasure AI veröffentlicht die Leistungsgrenzen von Real-Time 2.0:
| Messgröße | Veröffentlichte Angabe |
|---|---|
| Antwort der Personalization API | ≤100 ms bei p95 für bis zu 20 Attribute; die SLA setzt Enterprise Support voraus |
| Ausgelöste Aktivierungen | Bis zu 3 Minuten vom Ereignis bis zum Versand, einschließlich Auswertung, Zuordnung der Kennungen und Übergabe |
| Datenerfassung im Strom | Standardmäßig 2.000 Ereignisse pro Sekunde je Kunde; die gesamte Plattform skaliert weltweit auf 100.000 und mehr Ereignisse pro Sekunde |
| Durchsatz der Entscheidungsfunktion | 8.000 Ereignisse pro Sekunde je Kunde |
| Grenzen der Identitätsauflösung | Bis zu 100 Schlüssel für die Zuordnung von Kennungen; bis zu 200 Kennungen je Profil, die ältesten werden zuerst entfernt |
| Echtzeitmerkmale | Bis zu 200 je Profil, jeweils 500 Byte |
Zwei Veröffentlichungen aus dem Jahr 2026 ergänzen die Echtzeitschicht. Der Lookup Catalog vom 17. Juli gleicht zur Laufzeit Profilmerkmale mit einer externen Referenztabelle ab, etwa für produktbezogene Entscheidungen, Coupon-Erinnerungen oder zeitlich begrenzte Angebote. Echtzeitprotokolle für Identitäten vom 14. September halten abgewiesene Kennungen, beim Limit von 200 entfernte Kennungen und eingehende Kennungen bei jeder Zusammenführung fest. So kann das Datenteam prüfen, wie Profile verbunden wurden.
Für die Bewertung sind die beiden Zeitangaben getrennt zu messen. Eine Personalisierung während des Besuchs hängt von der Antwortzeit der Personalization API ab: ≤100 ms bei p95 gelten für bis zu 20 Attribute mit Enterprise Support. Die Nachfassnachricht läuft dagegen über die ausgelöste Aktivierung mit einer Obergrenze von 3 Minuten. Bei 100 oder mehr übergeordneten Segmenten sollte ein Proof of Concept die Leistung prüfen. Wer nur wöchentliche Kampagnen und monatliche Berichte braucht, benötigt die Echtzeitschicht möglicherweise nicht.
Ergebnisse aus der Early-Access-Phase
In der Early-Access-Phase 2026 veröffentlichte Treasure AI zwei Ergebnisse aus dem Einsatz bei Großkunden, beide laut Herstellerangabe ohne unabhängige Prüfung. Ein Händler komprimierte den Weg vom Segment zum Kampagnenstart von fünf Tagen auf acht Stunden und entdeckte dabei ein 340.000-Profile-Hochinteresse-Segment, das die manuelle Analyse übersehen hatte; die Conversion stieg um 23 %. Dasselbe Finanzanalyseteam aus dem Abschnitt zu den Supervisor-Agenten ersetzte seinen dreitägigen Berichtszyklus durch Abfragen in natürlicher Sprache mit einer Antwortzeit von 60 Sekunden.
Beide Angaben stammen vom Hersteller selbst und beschreiben frühe Einführungen. Unabhängige Prüfung durch Analysten und breitere Messungen an Kunden fehlen noch.
Der Customer Intelligence Loop
Der Customer Intelligence Loop ist ein fünfstufiger, fortlaufender Zyklus, der beschreibt, wie Kundendaten von der Erfassung bis zur Aktivierung fließen und wie das Ergebnis einer Interaktion die nächste Entscheidung verbessert. Viele Marketingstacks durchlaufen denselben Weg in getrennten Schritten: Ein Warehouse sammelt die Daten, ein anderes Werkzeug löst die Identitäten auf, ein drittes baut Segmente, ein viertes versendet. Jede Übergabe kostet Zeit und Kontext. Der Customer Intelligence Loop ist das Ordnungsprinzip von Treasure AI für diese Lücken: Alle fünf Stufen laufen in einer Plattform, und KI-Agenten treiben den Loop ohne wartenden Stapelzyklus an.
ERFASSEN → VEREINHEITLICHEN → VERSTEHEN → ENTSCHEIDEN → ANSPRECHEN → (zurück zu ERFASSEN)
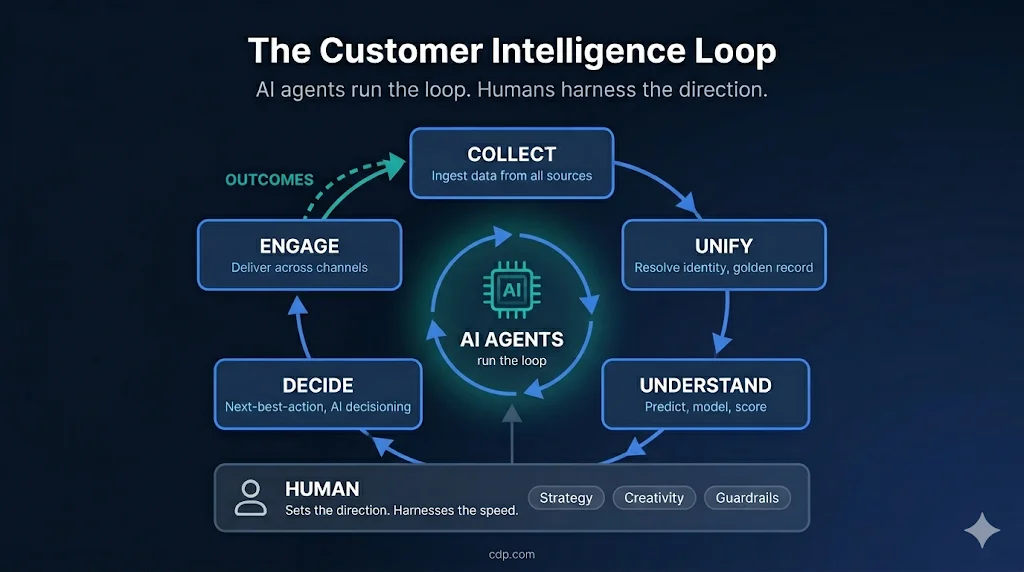
| Stufe | Was geschieht | Fähigkeit der Plattform |
|---|---|---|
| ERFASSEN | Daten aus jeder Quelle einziehen – Verhalten, Transaktionen, CRM, Support, IoT | über 170 Konnektoren, Streaming und Stapel |
| VEREINHEITLICHEN | Identitäten über Geräte, Kanäle und Konten auflösen | ML-basierte Identitätsauflösung, deterministisch und probabilistisch |
| VERSTEHEN | Kundenverhalten analysieren, Absicht vorhersagen, Kaufwahrscheinlichkeit bewerten | Predictive Analytics, LTV-Modellierung, Churn-Vorhersage |
| ENTSCHEIDEN | für jeden Kunden die nächstbeste Aktion bestimmen | KI-Entscheidung, Echtzeit-Auswahl des Angebots |
| ANSPRECHEN | personalisierte Erlebnisse über Kanäle ausführen | natives omnichannel-Messaging, Aktivierung in externe Systeme |
Die Ergebnisse der Interaktion – E-Mail-Öffnungen, Käufe, Supportanfragen – fließen in die ERFASSEN-Stufe zurück und schließen den Kreis. In der agentenbasierten Ausführung treiben Agenten den Loop fortlaufend an, ohne den Takt menschlich gestarteter Kampagnen abzuwarten. Für Organisationen, die wöchentliche Stapelkampagnen fahren und keine Echtzeit- oder Sitzungsanforderungen haben, lohnt der fortlaufende Loop nicht in jedem Fall: Eine Composable-Architektur mit täglichem oder wöchentlichem Rhythmus kann denselben Nutzen bei weniger Komplexität liefern.
Governance und Sicherheit
Data Governance ist für jede Plattform Pflicht, die personenbezogene Daten im großen Maßstab verarbeitet. Zu den Fähigkeiten von Treasure AI unter diesem Titel gehören:
- Konformitätszertifikate: SOC 2 Typ II, DSGVO-konforme Verarbeitung, der CCPA als amerikanische Referenz; die Plattform ist für den in den USA relevanten HIPAA-Rahmen geeignet, in Deutschland ohne Anwendungsfall
- Infrastruktur: Betrieb auf AWS mit Bedrock-Anbindung für KI-Workloads
- Prüfpfad: manipulationssicheres Protokoll aller Datenzugriffe, Agentenaktionen und Aktivierungsereignisse
- Consent-Management (Einwilligungsverwaltung): einheitliche Durchsetzung der Einwilligung über alle Aktivierungskanäle
- Speicherort der Daten: regionale Speicheroptionen für Unternehmen mit Lokalisierungsanforderungen
- Organisationsweite Anweisungen für KI-Agenten: Administratoren können bis zu 16.384 Zeichen an Vorgaben hinterlegen, die bei neuen Chats in den System-Prompt jedes AI-Studio-Agenten der Organisation eingehen. Die Vorgaben steuern das Verhalten; den Datenzugriff regeln weiterhin die durchgesetzten Berechtigungen und nicht der Prompt
- KI-Datenrichtlinie: die Kundendaten dienen nie dem Training der KI-Modelle des Anbieters
Die vollständige Liste der Zertifikate und Sicherheitsdokumente führt das Treasure AI Trust Center.
Der manipulationssichere Prüfpfad wiegt in regulierten Branchen besonders schwer: Finanzdienstleister und Gesundheitsorganisationen brauchen nachweisbare Aufzeichnungen, wer oder welcher Agent auf Kundendaten zugegriffen hat und welche Aktionen folgten. Für den Einsatz in Deutschland kommt die Regulierungslage hinzu:
Für Unternehmen in Deutschland gilt für die Verarbeitung personenbezogener Daten die Datenschutz-Grundverordnung (DSGVO, GDPR); das Bundesdatenschutzgesetz (BDSG) ergänzt sie als deutsches Recht, und für das Setzen von Cookies und den Zugriff auf Endgeräte kommt das TDDDG (bis Mai 2024 TTDSG) hinzu. Für Unternehmen mit mindestens 20 Personen, die ständig mit automatisierter Verarbeitung personenbezogener Daten betraut sind, ist der Datenschutzbeauftragte Pflicht.
Zwischen dem Unternehmen und dem Anbieter liegt ein Auftragsverarbeitungsvertrag nach Art. 28 DSGVO; die Liste der Unterauftragsverarbeiter und die technischen und organisatorischen Maßnahmen stehen im Vertrag, nicht auf der Produktseite. Für eine Übermittlung in ein Land außerhalb der EU braucht der Datenfluss einen Angemessenheitsbeschluss (das EU-US-Datenschutzrahmenwerk ist das geltende Instrument) oder Standardvertragsklauseln, und wo eine Aufbewahrungspflicht die Löschung ausschließt (Handels- und Steuerrecht verlangen in Deutschland 8 bis 10 Jahre), tritt die Einschränkung der Verarbeitung (Art. 18 DSGVO) an die Stelle der Löschung. Der Kunde wählt die Speicherregion; Treasure AI nennt für den europäischen Betrieb die Region eu01, keine eigene Region in Deutschland. Diese Regulierungsaussagen erheben keinen Anspruch auf Rechtsberatung; der Datenschutzbeauftragte des Unternehmens prüft die eigene Einführung gegen den Vertrag und die geltenden Fassungen der Gesetze.
Für einen Vergleich der sechs Anbieter nach Kriterien für Deutschland, je nach Speicherort und Präsenz im deutschen Markt, dient die Seite Die besten CDP-Anbieter in Deutschland 2026.
Für wen Treasure AI passt
Treasure AI eignet sich am ehesten für Organisationen, die sechs Anforderungen an eine Plattform stellen:
- Den vollständigen Customer Intelligence Loop in einer Plattform führen – Erfassung, Identitätsauflösung, KI-Entscheidung und Aktivierung, ohne die Stufen auf mehrere Anbieter zu verteilen
- Agenten auf vereinheitlichten Kundendaten einsetzen – nicht nur Dashboards für Menschen, sondern einen kontinuierlich laufenden agentenbasierten Betrieb
- Regulierungsaufgaben im großen Maßstab erfüllen – Einwilligung, Datenschutzkonformität und CCPA mit prüfbaren Agentenaktionen
- Mehrere Kanäle bedienen – E-Mail, SMS, Push, In-App, Web-Personalisierung und Aktivierung in Werbesysteme
- An bestehende Data-Warehouse-Umgebungen angebunden sein – Composable Audience Studio baut und aktiviert Zielgruppen direkt auf Tabellen in Snowflake, Databricks und BigQuery; KI-Agenten im Studio können in einem Chat außerdem Snowflake und Databricks abfragen
- Asiatisch-pazifische Märkte betreuen – die native LINE-Anbindung und regionale Speicheroptionen sind für diese Konstellation der Vorteil
Ein anderer Architekturtyp passt besser, wenn:
- Reverse ETL genügt: Organisationen mit ausgereiftem Data Warehouse, bestehender Segmentierungslogik in SQL und ohne Bedarf an Identitätsauflösung, KI-Entscheidung oder nativem Messaging erreichen dasselbe Ergebnis mit einem eigenständigen Reverse-ETL-Werkzeug. Das hybride Modell von Treasure AI bindet dieselben Warehouses an, aber die volle Plattform kann mehr Fähigkeit sein, als der Anwendungsfall verlangt.
- die Organisation auf eine Suite festgelegt ist: Wer ausschließlich Adobe oder Salesforce einsetzt, erreicht innerhalb dieses Ökosystems engere Integration, bei den Kosten der Suite (suite tax). Wer beide Suiten betreibt oder Suite-Produkte mit den führenden Einzelwerkzeugen mischt, gewinnt über eine anbieterübergreifende Plattform wie Treasure AI eine Profilbasis, die beide Suiten zusammenführt – dieselbe Arbeitsteilung zwischen Datenfundament und Ausführung, die jede plattformneutrale Architektur bietet.
- einfache Anforderungen und kleine Unternehmen: Unter 100.000 Profilen und mit ein bis zwei Kanälen braucht das Unternehmen die Enterprise-Fähigkeiten der Plattform eher nicht.
FAQ
Was ist aus Treasure Data geworden?
Treasure Data wurde am 20. April 2026 zu Treasure AI umbenannt. Die Domain wechselte von treasuredata.com zu treasure.ai, und das Produkt entwickelte sich von der Customer Data Platform zur agentischen Experience-Plattform. Vorhandene Integrationen, APIs und SDKs laufen unverändert weiter: Die Umbenennung ist eine Produktenwicklung, kein Bruch.
Wie unterscheidet sich Treasure AI von anderen CDPs?
Treasure AI bündelt CDP, omnichannel-Messaging und KI-Agenten in einer Plattform, die den Customer Intelligence Loop fortlaufend ausführt. Die meisten CDPs vereinheitlichen Daten und segmentieren, verlangen aber für Messaging und KI-Entscheidung getrennte Werkzeuge – typischerweise vier bis fünf Anbieter auf dem Weg vom Warehouse über Reverse ETL und Versandsystem bis zur KI-Schicht. Treasure AI hält alle fünf Stufen des Loops im eigenen Rahmen, ohne die Kopie personenbezogener Daten und ohne die Latenzen zwischen Anbietern, die Reverse ETL einführt. Ein detaillierter Vergleich steht im CDP Vendor Comparison Guide und für Deutschland in der Anbieterübersicht.
Ist Treasure AI die richtige CDP für meine Organisation?
Treasure AI passt zu internationalen Mehrmarkenunternehmen mit großen Datenbeständen und Bedarf über Regionen hinweg, und es passt nicht zu kleinen Teams, die eine Plattform zur Selbstbedienung suchen oder ein SMB-Budget führen. Wählen Sie den Anbieter für die Abdeckung aus eigener Kraft: Packaged oder Composable, native KI und native Nachrichten in E-Mail, SMS und Push, ohne die Kopie personenbezogener Daten in ein separates Suite-Produkt. Greifen Sie zu einem anderen Architekturtyp, wenn das Team einfache Selbstbedienung braucht.
Ist Treasure AI eine CDP oder etwas anderes?
Treasure AI enthält eine vollständige CDP (Datenerfassung, Identitätsauflösung, Segmentierung, Aktivierung) und erweitert sie um natives Messaging und KI-Agenten. Die Bezeichnung „agentische Experience-Plattform“ beschreibt die zusätzliche Entscheidung und Ausführung durch die KI auf dem CDP-Fundament. Wer Treasure AI gegen andere CDPs abwägt, vergleicht die vollständige Abdeckung der Plattform, nicht nur die Datenvereinheitlichung. Die Weiterentwicklung der Kategorie beschreibt Was ist eine Agentic CDP? (auf Englisch).
Ist Treasure AI eine Echtzeit-CDP?
Ja: Treasure AI verarbeitet mit Real-Time 2.0 Ereignisse im Datenstrom in Millisekunden, führt Kennungen beim Eintreffen zusammen und nennt für die Personalization API eine SLA von höchstens 100 ms bei p95 für bis zu 20 Attribute mit Enterprise Support. Ausgelöste Aktivierungen erreichen ihr Ziel innerhalb von 3 Minuten. Parallel berechnet die Stapelverarbeitung nach Zeitplan Prognosewerte und aktualisiert Identitätsbeziehungen. Die Echtzeit-Engine liest beim Eintreffen eines Ereignisses das gespeicherte Profil, sodass Entscheidungen auch die Kundenhistorie berücksichtigen.
Funktioniert Treasure AI mit Snowflake, Databricks und BigQuery?
Ja: Mit Composable Audience Studio baut und aktiviert Treasure AI Zielgruppen direkt auf Tabellen in Snowflake, Databricks und BigQuery, ohne die Quelldaten in Treasure AI zu kopieren. Die Abfragen laufen auf Rechenkapazität des Data Warehouse des Kunden und werden dort abgerechnet; das Datenteam pflegt die Schemata. KI-Agenten in AI Studio können Snowflake und Databricks zusätzlich über einzeln autorisierte OAuth-Verbindungen im Chat abfragen.
Wo hat Treasure AI seinen europäischen Betrieb?
Für den europäischen Betrieb nennt Treasure AI die Region eu01 in der eigenen Dokumentation; eine eigene deutsche Region ist nicht veröffentlicht. Treasure AI hat keine Niederlassung und kein Personal in Deutschland; der Markt Europa, Nahost und Afrika wird aus London und Nizza betreut. Für Unternehmen in Deutschland ist der Speicherort der personenbezogenen Daten damit eine Vertragfrage: Prüfen Sie die Region im Auftragsverarbeitungsvertrag und in der Liste der Unterauftragsverarbeiter, nicht auf der Produktseite. Der Vergleich der Speicherregionen für alle sechs Anbieter steht in der Anbieterübersicht für Deutschland.
Verwandte Artikel
- Die besten CDP-Anbieter in Deutschland 2026 – die sechs Anbieter des deutschen Markts im Vergleich, mit Zeile zu Treasure AI
- Was ist eine Customer Data Platform (CDP)? – die Grundlagen der Kundendatenplattform
- CDP auswählen: 10 Fragen für das KI-Zeitalter – das Bewertungsraster, angewendet auf Treasure AI
- Treasure AI (ehemals Treasure Data) – das vollständige englische Profil mit allen Zahlen
- Adobe Real-Time CDP – das Profil der CDP in der Adobe-Suite
- Salesforce Data Cloud – das Profil der CDP in der Salesforce-Suite
Lesen Sie nach, wie Analysten die CDP-Anbieter einstufen: IDC MarketScape und Forrester Wave
Diese Seite ist auch in folgenden Sprachen verfügbar: What Is Treasure AI (Formerly Treasure Data)? · Treasure AI(旧Treasure Data)とは?特徴と沿革 · O que é Treasure AI (ex-Treasure Data)? · ¿Qué es Treasure AI (antes Treasure Data)? · Treasure Data (Treasure AI) : la CDP, ses limites