Treasure AI (ex-Treasure Data) é uma plataforma de experiência agêntica (Agentic Experience Platform) que unifica dados de cliente de qualquer fonte, resolve identidades entre canais e implementa agentes de IA para conduzir personalização, mensageria e decisão autonomamente, sob a direção da criatividade e do julgamento estratégico das pessoas.
A plataforma nasceu como uma das primeiras plataformas de dados do cliente (CDP, ou Customer Data Platform) e se tornou um único produto que reúne CDP, mensageria multicanal e IA para rodar o Customer Intelligence Loop continuamente.
Divulgação: a cdp.com é operada pela Treasure Data (hoje Treasure AI). Este perfil segue os mesmos critérios editoriais dos demais perfis de fornecedor do site, documentados na nossa política editorial, mas o leitor precisa conhecer essa relação. Para o comparativo lado a lado de todos os fornecedores de CDP, veja o guia de fornecedores de CDP.
Treasure AI em resumo
| Dimensão | Treasure AI |
|---|---|
| Indicado para | Empresas globais e multimarca, B2C e B2B, com ambientes de dados de grande escala, sobretudo as que precisam de cobertura na Ásia-Pacífico (APAC) e de residência de dados multirregião |
| Porte típico do comprador | Média empresa e grande empresa: 39,9% das 163 avaliações que o G2 classifica por porte vêm de empresas acima de 1.000 funcionários, 36,8% de empresas na faixa de 51 a 1.000 e 23,3% de empresas com até 50 |
| Modelo de preço | Por perfil e por evento, sob consulta; no modo Complete CDP, consultas e segmentação não têm cobrança separada de processamento. No modo Composable, as consultas usam o processamento do data warehouse do cliente e entram na conta desse ambiente |
| Implementação típica | De 4 a 8 semanas na fase inicial; de 3 a 6 meses para a implantação corporativa completa |
| Principal diferencial | O maior leque de capacidades entre as CDPs Packaged deste site: implantação Packaged ou Composable, IA preditiva e agêntica nativa e mensageria nativa por e-mail, SMS e push dentro de um mesmo limite de plataforma — com conectores nativos da Ásia-Pacífico (LINE, Yahoo! JAPAN Ads) como encaixe adicional para a região |
| Evite se | Você precisa de autonomia da equipe de marketing ou tem orçamento de pequena e média empresa |
Essa divisão descreve quem avalia o fornecedor no G2, não a base de clientes: os revisores se autosselecionam e os fornecedores fazem campanha de solicitação de avaliações. As contagens são o subconjunto que o G2 classifica por porte, menor que o total de avaliações citado em outro ponto da página; quando a página não traz uma divisão por porte, a linha se apoia no fato estrutural que ela mesma enuncia. O comparativo entre fornecedores de CDP e a metodologia desses percentuais estão em fornecedores de CDP.
Histórico da empresa
A Treasure Data foi fundada em 2011 em Mountain View, na Califórnia, como uma plataforma de gerenciamento de dados em nuvem para dados de log e análise de big data. Nos anos seguintes, a empresa mudou o foco para os dados de cliente e construiu a infraestrutura de ingestão de dados, resolução de identidade e ativação de público em grande escala que se tornou a sua plataforma de dados do cliente.
Marcos principais:
| Ano | Marco |
|---|---|
| 2011 | Fundada em Mountain View, Califórnia, como plataforma de gerenciamento de big data |
| 2013 | Expansão para a gestão corporativa de dados de cliente |
| 2018 | Aquisição pela Arm Holdings (SoftBank Group) por cerca de US$ 600 milhões, o que acelerou a entrada no mercado corporativo |
| 2020 | Nomeada Leader no Forrester Wave de Customer Analytics Technologies |
| 2022 | Nomeada Strong Performer no Forrester Wave de CDPs |
| 2024 | Nomeada Leader no Forrester Wave de CDPs de 2024, com reconhecimento pela solidez da base de dados e pela escalabilidade corporativa |
| 2026 | Mudança de marca de Treasure Data para Treasure AI e lançamento da plataforma de experiência agêntica |
| 2026 | Nomeada Leader no IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2C Users (Doc #US53952526) |
| 2026 | Nomeada Leader no IDC MarketScape for Worldwide AI-Enabled Customer Data Platforms for B2B Users (Doc #US53952326), o que a torna Leader nos recortes B2B e B2C, distinção que divide com a Salesforce |
Em 2026, a Treasure AI atende mais de 400 clientes corporativos em varejo, serviços financeiros, saúde, automotivo, bens de consumo e mídia. A plataforma processa bilhões de perfis unificados no mundo todo.
A mudança de marca: de Treasure Data para Treasure AI
Em 20 de abril de 2026, a Treasure Data passou a se chamar oficialmente Treasure AI. O domínio da empresa mudou de treasuredata.com para treasure.ai, e a categoria de produto passou de “Customer Data Platform” para “Agentic Experience Platform”.
A mudança de marca (rebranding) reflete uma alteração estrutural no que a plataforma faz. A Treasure Data começou como um sistema em que pessoas acessavam dados de cliente unificados para decidir o que fazer no marketing. A Treasure AI é projetada como um sistema em que agentes de IA acessam esses mesmos dados unificados para decidir e executar autonomamente, com as pessoas fornecendo estratégia, criatividade e guardrails.
Três mudanças definem a transição:
-
De plataforma de dados para plataforma de experiência. A CDP original cuidava da ingestão, da unificação e da ativação de público. A nova plataforma acrescenta mensageria multicanal nativa (e-mail, SMS, push, mensagem no aplicativo, LINE), decisão com IA e personalização em tempo real, o que dispensa um fornecedor diferente para cada etapa do Customer Intelligence Loop.
-
De arquitetura centrada em pessoas para arquitetura centrada em agentes. A interface principal da plataforma está migrando de painéis e construtores de consulta para agentes de IA que operam por MCP (Model Context Protocol), CLI, APIs e habilidades prontas de agente. As pessoas continuam dirigindo a estratégia; os agentes de IA cuidam da execução em escala.
-
De ciclos em lote para ciclos contínuos. A CDP executava a segmentação de clientes em lotes diários ou semanais. A plataforma de experiência agêntica roda o Customer Intelligence Loop continuamente: COLETAR, UNIFICAR, ENTENDER, DECIDIR e ENGAJAR em minutos, com o resultado do engajamento voltando para orientar o ciclo seguinte.
Todas as APIs, SDKs e fluxos de trabalho existentes continuam retrocompatíveis. A mudança de marca é uma evolução de produto, não uma migração que quebra as integrações já em produção.
Arquitetura da plataforma
A Treasure AI usa uma arquitetura híbrida que separa o plano de controle do plano de dados:
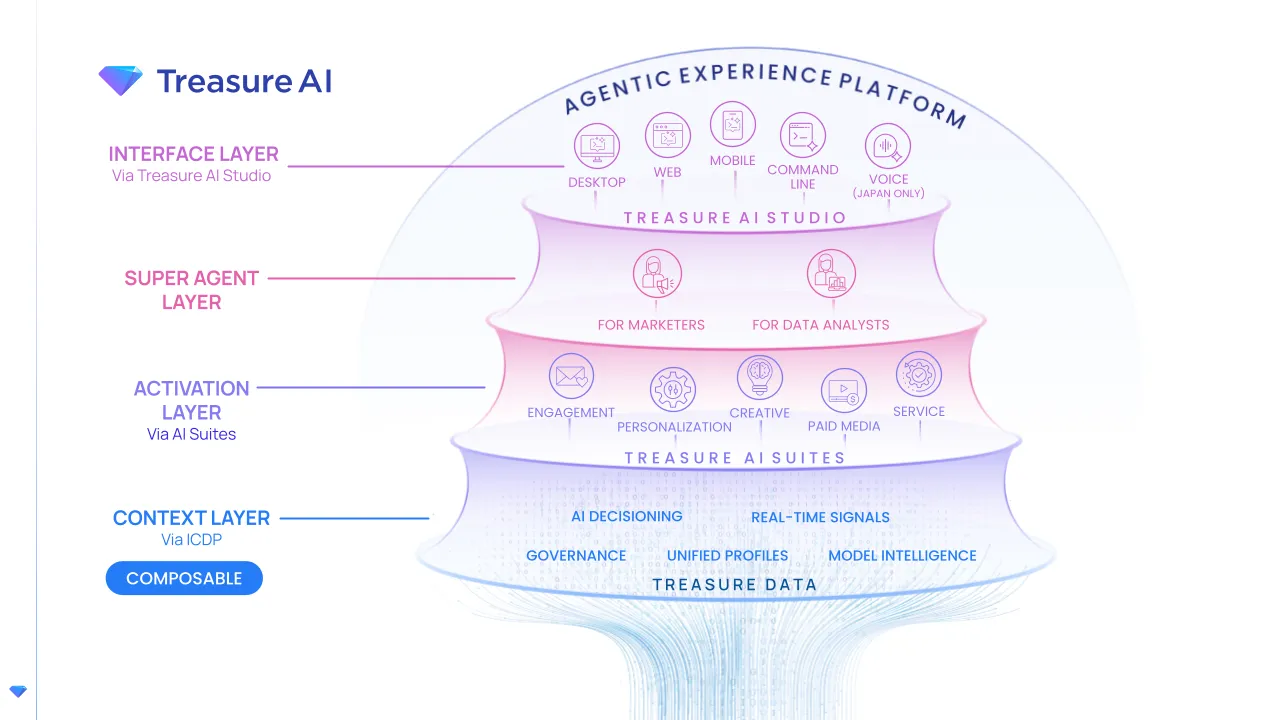
Arquitetura da plataforma de experiência agêntica da Treasure AI. A plataforma é composable na camada de contexto (iCDP) e reúne ativação, agentes de IA e interfaces de várias superfícies acima dela.
-
Plano de controle (Treasure AI): resolução de identidade, segmentação de público, decisão com IA, orquestração de mensageria e o runtime (ambiente de execução) dos agentes de IA. É a camada gerenciada da plataforma, em que o Customer Intelligence Loop é executado.
-
Plano de dados (infraestrutura do cliente): os dados de cliente podem ficar no data warehouse do próprio cliente: Snowflake, Databricks ou BigQuery. A Treasure AI consulta as tabelas nesse ambiente sem exigir que os dados sejam movidos para um armazenamento proprietário. Na direção inversa, esses mesmos warehouses podem consultar, sem uma segunda cópia, as tabelas gerenciadas pela Treasure AI que são publicadas no formato Apache Iceberg para leitura.
Esse modelo de implantação híbrido ataca uma tensão central do mercado de CDP. As CDPs composable mantêm os dados no warehouse, mas não conseguem rodar ciclos de IA em tempo real na velocidade de uma API; as CDPs packaged são rápidas, mas exigem copiar todos os dados para um armazenamento proprietário. A arquitetura da Treasure AI busca entregar as duas coisas: dados residentes no warehouse com um plano de controle gerenciado, projetado para leitura de perfil de baixa latência e ativação em tempo real.
Principais produtos
Treasure AI Studio
O Treasure AI Studio é a interface principal da plataforma e está disponível em várias superfícies:
- Web: espaço de trabalho no navegador, para marketing, análise e times de dados
- Desktop: aplicativo nativo para macOS e Windows
- Mobile: iOS e Android, para acompanhamento e aprovações fora do escritório
- CLI (Treasure Code): interface de linha de comando para engenheiros e times de dados interagirem com a plataforma de forma programática. O Treasure Code é construído sobre o Claude Code e dá acesso a dados de cliente, inspeção de esquema e operações de pipeline direto do terminal
- Voz (Treasure AI Voice): interface de voz com IA para consultar dados e registrar anotações sem usar as mãos
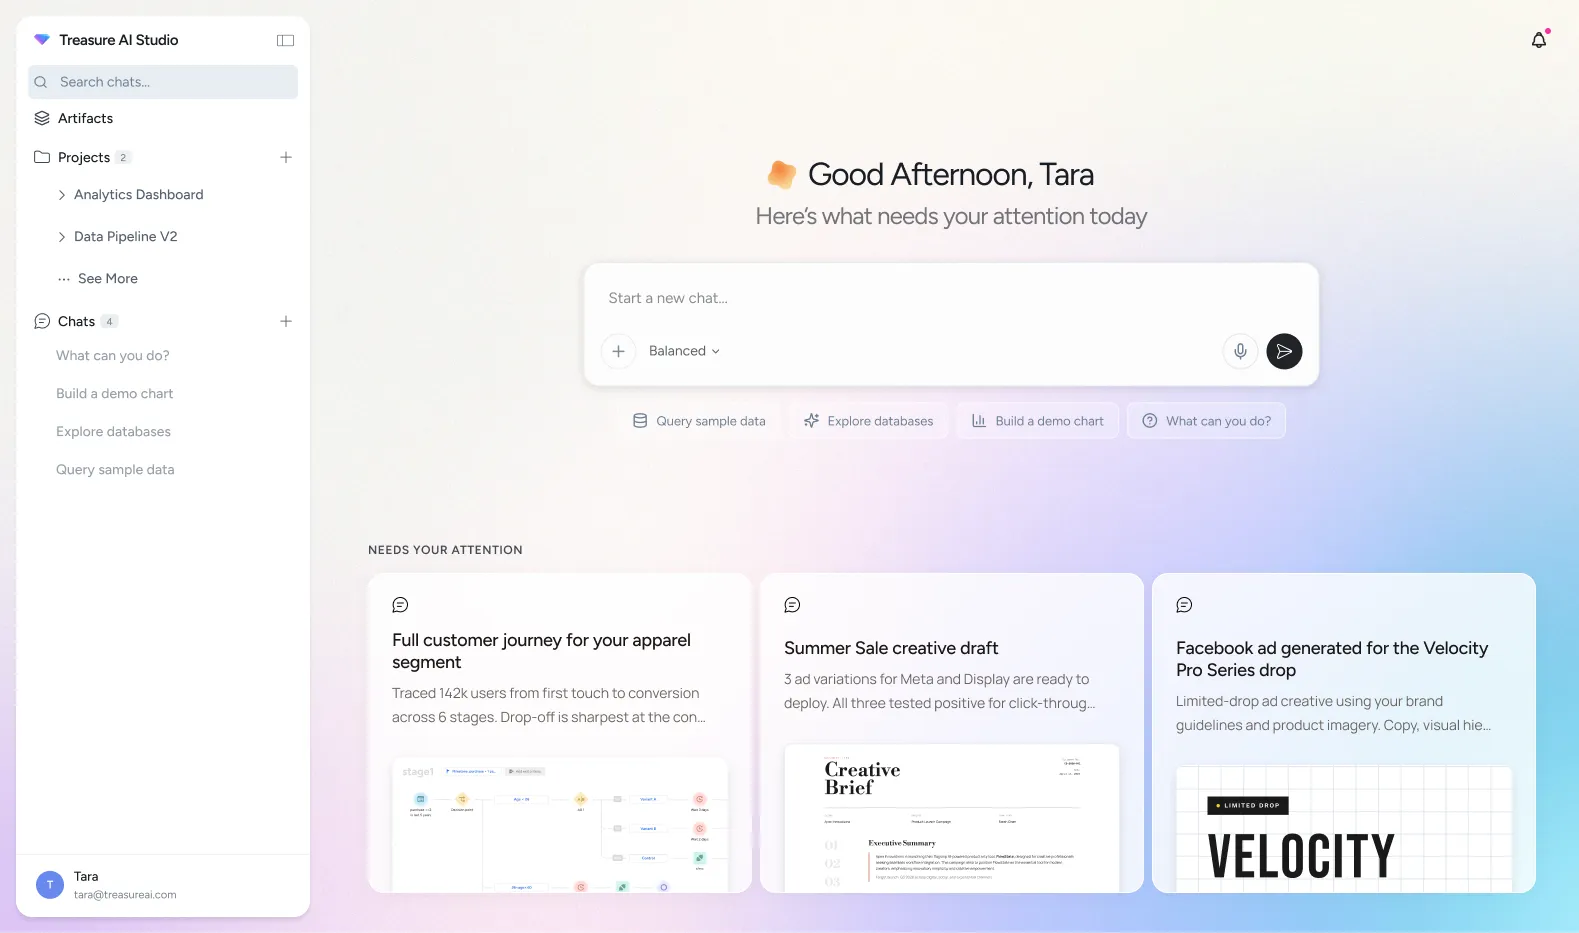
O Studio dá acesso em linguagem natural a dados de cliente, criação de segmentos, gestão de campanhas e análise. A interface foi projetada para que usuários sem perfil técnico consultem e ajam sobre os dados de cliente sem SQL e sem apoio de engenharia.
Os agentes do Studio também consultam dados fora da Treasure AI. Desde junho de 2026, as conexões do AI Studio permitem explorar e visualizar, em uma conversa, dados no Snowflake (incluído em 25 de junho) ou no Databricks (17 de junho). Um conector incluído em 14 de julho trouxe a própria CDP da Treasure Data para o mesmo modelo: o agente pode executar consultas, fluxos de trabalho e operações com segmentos de público durante a conversa. O administrador registra cada conector uma vez por organização via OAuth; depois, cada usuário autoriza a própria conexão. O agente recebe apenas um token substituto, enquanto a credencial real é inserida no limite da rede (nota de lançamento de junho de 2026). O agente só enxerga os dados aos quais a função autorizada no warehouse tem acesso. No caso do conector Snowflake do AI Studio, essa função é a PUBLIC: uma tabela liberada para uso pelo agente também fica visível a todos os demais usuários do Snowflake. Por isso, as permissões precisam ser delimitadas. O Composable Audience Studio, descrito adiante, usa uma credencial Snowflake configurada separadamente.
O contexto de trabalho do Studio fica em pastas de trabalho (work folders), não apenas no histórico de cada conversa. Cada pasta guarda um arquivo de instruções que a IA lê ao iniciar uma conversa e pode atualizar à medida que o trabalho avança. Nomes de tabelas, convenções e objetivos continuam disponíveis nas conversas seguintes (documentação da memória entre conversas). Desde 17 de setembro de 2026, uma pasta pode ser compartilhada entre os membros de uma conta. O grupo passa a trabalhar na mesma árvore de arquivos, que contém instruções, arquivos de referência, habilidades e ações salvas, mas cada pessoa usa seu próprio agente de IA. Por exemplo, uma equipe pode registrar na pasta quais tabelas entram no relatório semanal de campanhas, quais segmentos considerar e como apresentar o resultado. Outro membro começa com esse contexto, sem reconstruir o pedido. O que o agente de cada membro grava na pasta, conforme suas permissões, serve de ponto de partida para a conversa seguinte.
Compartilhar a pasta não compartilha as conversas nem o diretório pessoal my/ de cada membro. Os modos de trabalho determinam onde cada agente pode escrever no espaço compartilhado: em lugar nenhum, apenas em pastas de primeiro nível nomeadas ou em toda a área. A restrição é aplicada pelo sistema de arquivos, não por uma instrução no prompt. Os responsáveis pela pasta controlam o acesso; mesmo um administrador da conta não consegue ler uma pasta compartilhada se não tiver um modo de trabalho nela (controle de acesso).
A pasta também pode guardar fluxos recorrentes. As Work Folder Actions, lançadas em 13 de agosto de 2026, salvam um fluxo para execução sob demanda. Desde 25 de agosto, as Action Schedules executam essas ações diariamente, em dias úteis, toda semana, todo mês ou em um cron personalizado, sem que uma pessoa precise iniciar o fluxo (nota de lançamento de agosto de 2026). Esse agendamento serve para análises e relatórios periódicos; não reage a eventos de cliente no momento em que ocorrem. Para isso, a plataforma usa a camada de tempo real.
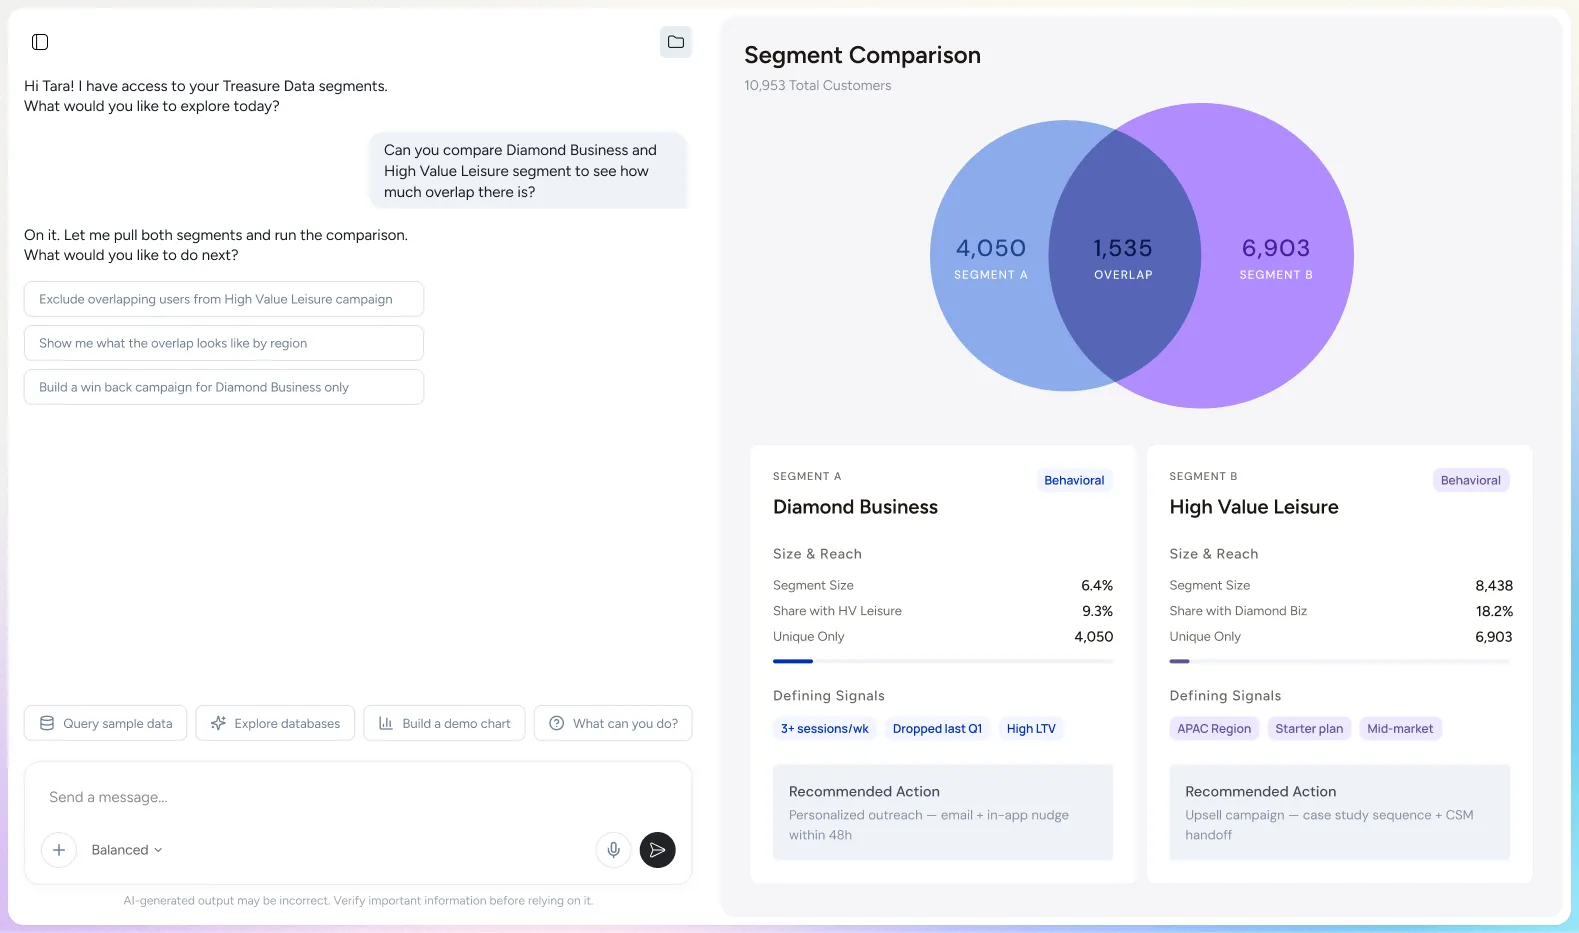
Comparação de segmentos no Treasure AI Studio. Uma consulta em linguagem natural dispara a análise de sobreposição de públicos e devolve as próximas ações recomendadas, um exemplo de como os agentes de IA trazem os insights à tona sem SQL manual nem fluxo de BI.
AI Super Agents
Os AI Super Agents são agentes de IA prontos e especializados por domínio, que automatizam fluxos de trabalho específicos dentro do Customer Intelligence Loop:
-
AI Super Agent for Marketers: cuida da descoberta de públicos, da criação de campanhas, da recomendação de próxima melhor ação e da ativação entre canais. Em vez de passar horas montando à mão um segmento de reconquista, o profissional de marketing descreve o objetivo (“encontre clientes que compraram no primeiro trimestre e não interagem há 60 dias”) e o agente monta o segmento, escolhe os canais e lança a campanha.
-
AI Super Agent for Data Analysts: automatiza a exploração de dados, a geração de insights e a criação de relatórios. O analista pergunta em linguagem simples e recebe respostas estruturadas, com visualizações de apoio. No acesso antecipado (early access), uma equipe de serviços financeiros relatou ter reduzido o tempo de entrega de relatórios de três dias para 60 segundos nas consultas de rotina sobre clientes.
Esses agentes são construídos sobre a base unificada de dados de cliente da plataforma, o que significa que eles operam sobre perfis completos e já resolvidos, não sobre dados fragmentados em ferramentas isoladas.
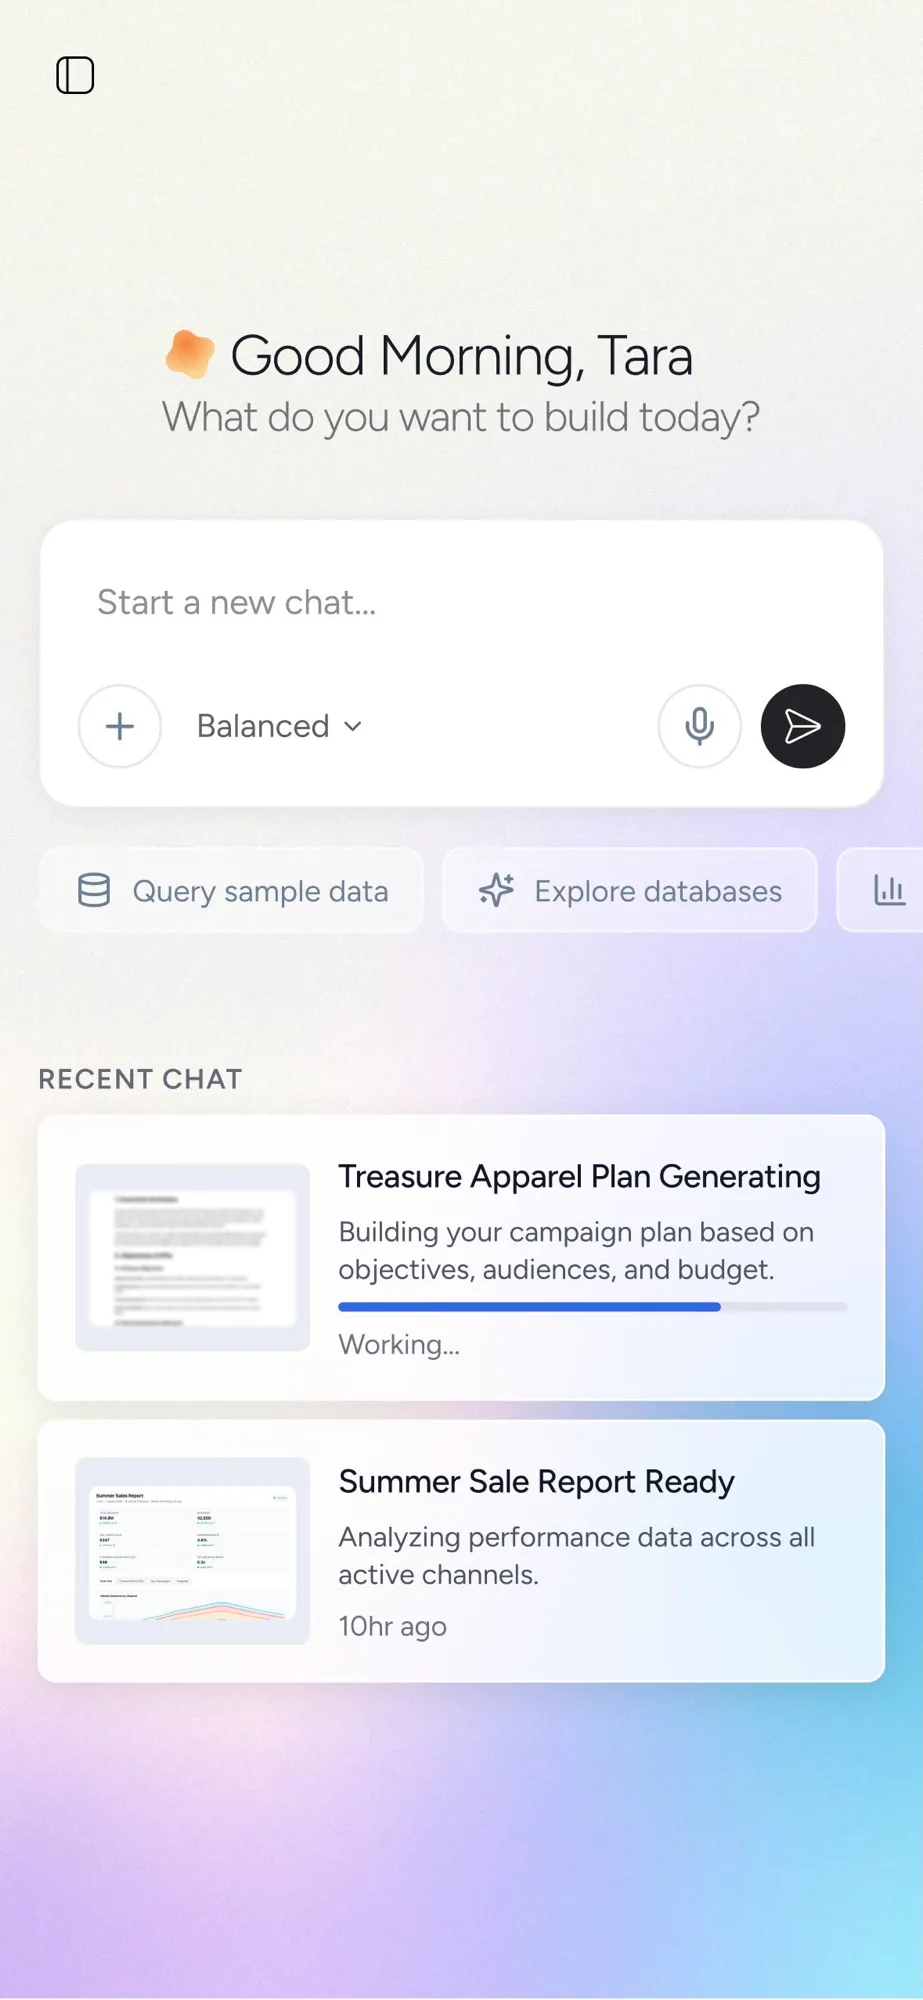
Treasure AI Studio no celular. A mesma interface conversacional disponível em iOS e Android, para acompanhar campanhas e aprovar ações fora do escritório.
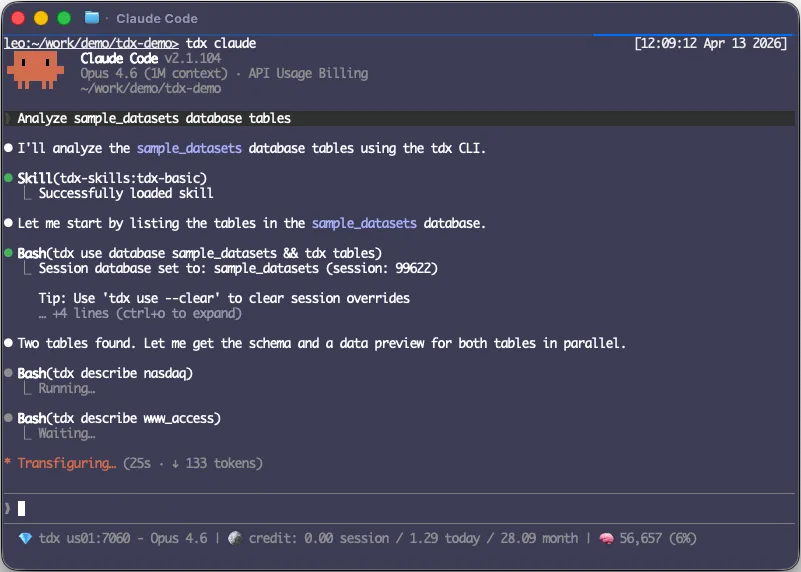
Treasure Code (CLI). Engenheiros interagem com a Treasure AI por uma interface de terminal construída sobre o Claude Code: inspecionam esquemas, executam consultas e gerenciam pipelines de dados sem sair da linha de comando.
Mensageria multicanal
A plataforma inclui recursos nativos de mensageria nos seguintes canais:
- E-mail: conteúdo personalizado com otimização do horário de envio por IA (Email Marketing)
- SMS: mensagens transacionais e promocionais; desde setembro de 2026, links curtos por destinatário com rastreamento nativo de cliques (SMS Marketing)
- Push: notificações para iOS e Android (Mobile App Marketing)
- Mensagem no aplicativo: mensagens contextuais dentro dos aplicativos móveis
- LINE: integração nativa com a plataforma de mensagens LINE (relevante para os mercados da Ásia-Pacífico); desde agosto de 2026, mensagens de contas oficiais LINE em texto, Imagemap e Flex também podem integrar campanhas contínuas junto a e-mail e push
O WhatsApp, canal dominante no relacionamento com o consumidor brasileiro, não aparece nessa lista de canais nativos. Em uma avaliação conduzida no Brasil, pergunte ao fornecedor por qual caminho o canal é atendido, se por integração, por parceiro ou pela API oficial, e quanto do resultado volta para o perfil.
Trazer a mensageria para dentro da plataforma, em vez de exigir uma plataforma de engajamento do cliente separada, faz com que os resultados de engajamento (aberturas, cliques, conversões) voltem direto para o Customer Intelligence Loop, sem a latência de atravessar a fronteira entre fornecedores.
Treasure Data (CDP): a camada de contexto
A base de toda a plataforma é a Treasure Data, a CDP inteligente que funciona como camada de contexto. É nessa camada que os dados de cliente são ingeridos, as identidades são resolvidas, os perfis unificados são construídos e as políticas de governança são aplicadas. Todos os produtos acima (Studio, Super Agents e mensageria) leem e escrevem nela.
Capacidades centrais da camada de contexto:
- Ingestão de dados: mais de 170 conectores prontos para ingestão em lote e por streaming, a partir de CRM, e-commerce, web analytics, PDV, atendimento e fontes de IoT
- Resolução de identidade: correspondência determinística e probabilística com aprendizado de máquina, que resolve identidades entre dispositivos, canais e contas
- Perfis unificados: perfis persistentes de visão 360° do cliente que agregam dados comportamentais, transacionais e demográficos em um registro só
- Decisão com IA e inteligência de modelos: análise preditiva, score de propensão e processamento de sinais em tempo real, que sustentam as etapas ENTENDER e DECIDIR do ciclo
- Governança de dados: controle de acesso por campo, aplicação do consentimento e automação de conformidade em toda a ativação a jusante
Essa é a camada marcada como “Composable” no diagrama de arquitetura: a empresa pode conectá-la ao data warehouse que já usa (Snowflake, Databricks, BigQuery) pelo modelo de implantação híbrido e manter os dados residentes no warehouse, enquanto a camada de contexto cuida de identidade, IA e governança.
A camada de contexto opera em dois modos. O Complete CDP é uma implantação gerenciada: os dados são ingeridos e armazenados na plataforma, com conectores prontos, resolução de identidade, segmentação e ativação, sem exigir um warehouse preexistente. No modo Composable CDP (Composable Audience Studio), a Treasure AI envia consultas federadas ao Snowflake, ao BigQuery ou ao Databricks. O warehouse executa as consultas com seu próprio processamento e devolve os resultados, sem uma sincronização por reverse ETL para um segundo repositório. A equipe de marketing monta públicos de forma visual enquanto as tabelas de origem permanecem no warehouse. Os resultados das consultas voltam à Treasure AI; os dados de cliente chegam a um destino quando o público é ativado. A plataforma também oferece resolução de identidade gerenciada, decisão com IA e mensageria nativa. Ao comparar esse modo com ferramentas puramente composable, verifique quais capacidades cada alternativa entrega nativamente, quais dependem de integração e quais estão disponíveis no modo de implantação escolhido. Veja a análise da arquitetura composable no guia brasileiro de fornecedores.
Composable Audience Studio no Snowflake, Databricks e BigQuery
O suporte aos warehouses ampliou o modo Composable em 2026. O Composable Audience Studio chegou ao Snowflake e ao Databricks em 27 de abril de 2026 e ao BigQuery em 11 de maio de 2026 (notas de abril e maio). Lançamentos posteriores acrescentaram trilha de auditoria, controle de acesso por segmento, atribuição de custo no warehouse e gestão por código:
| Data (2026) | Lançamento | O que muda para a equipe de dados |
|---|---|---|
| 27 de abril | Composable Audience Studio para Snowflake e Databricks | Segmentação, score preditivo e ativação sobre tabelas do warehouse, sem cópia para a Treasure AI |
| 11 de maio | Composable Audience Studio para BigQuery | Segmentação e ativação sobre tabelas do Google BigQuery |
| 10 de junho | Eventos no log de auditoria Premium | Mesma cobertura de log de auditoria do Audience Studio gerenciado, inclusive eventos de acesso negado |
| 30 de junho | Permissões baseadas em políticas | Acesso total, limitado ou negado por segmento principal composable e por pasta de segmentos |
| 24 de julho | Criação e atualização em YAML via tdx cas push | Públicos, atributos, comportamentos, segmentos e ativações gerenciados como código, com prévia antes da aplicação das alterações |
| 16 de agosto | Open Catalog Access | Na direção inversa, tabelas do Complete CDP publicadas no formato Apache Iceberg somente para leitura, para consulta no warehouse sem uma segunda cópia. Disponibilidade geral no Snowflake e no Databricks; BigQuery experimental. Habilitação mediante solicitação |
| 2 de setembro | Tags de consulta do Snowflake | Um QUERY_TAG em JSON identifica consultas de segmentação, ativação, busca de perfis e suporte. Permite atribuir o processamento do warehouse a públicos, segmentos e ativações para monitoramento ou rateio de custos |
Cada warehouse usa seu próprio modelo de credenciais, mas os três seguem o mesmo modelo de dados: um segmento principal composable parte de uma tabela de clientes com uma linha por perfil e um identificador único. Essa tabela se relaciona de um para muitos com tabelas de comportamento, cada uma com uma coluna de tempo (guia de configuração do Snowflake).
| Warehouse | Autenticação | Requisitos de configuração selecionados |
|---|---|---|
| Snowflake | Par de chaves | Um warehouse para executar consultas; usuário e função com permissão SELECT nas tabelas de destino |
| Databricks | Principal de serviço com OAuth | Unity Catalog habilitado; SQL warehouse ou cluster de processamento |
| BigQuery | Conta de serviço GCP com chave JSON | Permissão para criar contas de serviço e gerenciar funções IAM |
Nesse modo, a Treasure AI permite montar públicos sobre tabelas do warehouse e usa os controles de acesso do próprio ambiente. A contrapartida acompanha as consultas: a documentação do Composable CDP aponta custo variável de processamento no warehouse do cliente, além da responsabilidade da equipe de dados por modelar esquemas e ajustar o desempenho. A ausência de cópia vale para os dados em lote até a ativação; um público enviado à mídia ou a um canal de mensageria sai do warehouse, como ocorre em outras ferramentas composable. Quem prefere que a Treasure AI gerencie armazenamento e esquema pode optar pelo modo Complete CDP.
Real-Time 2.0: perfis em tempo real e dados por streaming
Um cliente volta ao site, põe uma jaqueta no carrinho, navega e sai. Ainda durante a sessão, uma oferta pode considerar tanto o carrinho atual quanto o histórico de compras. Depois que o cliente sai, um gatilho separado pode iniciar uma mensagem de acompanhamento. A camada Real-Time 2.0 da Treasure AI atende aos dois casos enviando cada evento recebido por dois caminhos simultâneos (visão geral de tempo real). No caminho em tempo real, o motor de decisão processa cada evento em milissegundos: faz a costura de identidade (identity stitching), atualiza atributos em tempo real, como contadores de sessão e valor do carrinho, e combina o evento com o perfil em lote (batch profile) armazenado. O caminho em lote executa fluxos programados, normalmente a cada poucos minutos ou horas, para agregar eventos históricos, calcular scores preditivos e atualizar relações de identidade. A cada novo evento de um cliente, o motor em tempo real lê o perfil em lote mais recente. A decisão durante a sessão, portanto, considera também o histórico do cliente.
A costura de identidade acontece no próprio fluxo de eventos. Quando os eventos trazem identificadores correspondentes em uma chave configurada para esse fim, as identidades são unificadas à medida que os eventos chegam. Por exemplo, um evento contém e-mail e ID de cookie; o seguinte contém o mesmo cookie e um ID de dispositivo. A unificação inclui identificadores conhecidos e anônimos (documentação sobre costura de identidade). A camada em lote continua sendo a fonte de referência dos perfis históricos.
A Treasure AI publica os limites operacionais da camada em tempo real (limites de desempenho):
| Dimensão | Limite publicado |
|---|---|
| Resposta da Personalization API | ≤100 ms no percentil 95 (p95) para até 20 atributos; o SLA exige Enterprise Support |
| Ativações por gatilho (triggered activations) | Até 3 minutos de ponta a ponta, incluindo avaliação, costura de identidade e envio |
| Ingestão por streaming | 2.000 eventos por segundo por cliente por padrão; a plataforma escala horizontalmente até 100.000+ eventos por segundo no mundo todo, não por cliente |
| Volume de decisões | 8.000 eventos por segundo por cliente |
| Limites de identidade | Até 100 chaves de costura de identidade; até 200 identificadores por perfil, com remoção dos mais antigos primeiro |
| Atributos em tempo real | Até 200 por perfil, de 500 bytes cada |
Dois lançamentos em 2026 ampliaram essa camada. O Lookup Catalog, lançado em 17 de julho, cruza atributos do perfil com uma tabela externa de referência durante a execução. A consulta pode orientar uma decisão por produto, um lembrete de cupom ou um banner de promoção com prazo limitado. As tabelas de log de identidade em tempo real, lançadas em 14 de setembro, registram valores rejeitados para costura, identificadores removidos ao atingir o limite de 200 e os IDs recebidos em cada mesclagem. Assim, a equipe de dados pode inspecionar como os perfis foram unidos.
Os dois prazos respondem a necessidades diferentes. Uma experiência no site depende do tempo de leitura da Personalization API, medido pelo SLA de ≤100 ms no p95 para até 20 atributos com Enterprise Support. Uma mensagem de acompanhamento após abandono depende da ativação por gatilho, cujo limite é de 3 minutos de ponta a ponta. Implantações com 100 ou mais segmentos principais pedem validação prévia em uma prova de conceito (POC). Para equipes que só executam campanhas semanais e relatórios mensais, talvez a camada em tempo real não seja necessária.
Resultados do acesso antecipado
Durante o acesso antecipado de 2026, a Treasure AI publicou dois resultados corporativos:
- Varejo corporativo: um cliente de varejo reduziu o tempo entre a criação do segmento e o lançamento da campanha de cinco dias para oito horas, com os AI Super Agents. O agente descobriu um segmento de alta intenção com 340 mil perfis que a análise manual não tinha encontrado, o que gerou um aumento de 23% na conversão.
- Serviços financeiros: uma equipe de análise de dados substituiu um ciclo de relatórios de três dias por consultas em linguagem natural de 60 segundos no Treasure AI Studio, o que liberou os analistas para a interpretação estratégica em vez da extração de dados.
Esses resultados foram relatados pelo próprio fornecedor e correspondem a implantações em estágio inicial. A validação independente de analistas e as referências mais amplas de clientes ainda não existem; elas tendem a aparecer conforme a plataforma amadurece além do acesso antecipado.
Customer Intelligence Loop
O Customer Intelligence Loop é um ciclo contínuo de cinco etapas que descreve como os dados de cliente fluem da coleta até a ativação, e como o resultado do engajamento volta para melhorar as decisões seguintes. A maior parte dos stacks de marketing roda esse ciclo em etapas desconectadas: um warehouse coleta os dados, uma ferramenta separada resolve as identidades, outra monta os segmentos e ainda outra envia as mensagens. Cada passagem de bastão acrescenta latência e perde contexto. O Customer Intelligence Loop é o princípio organizador da Treasure AI para eliminar essas lacunas: as cinco etapas são executadas dentro de uma plataforma só, e os agentes de IA percorrem o ciclo continuamente, em vez de esperar por lotes iniciados por pessoas.
COLETAR → UNIFICAR → ENTENDER → DECIDIR → ENGAJAR → (volta a COLETAR)
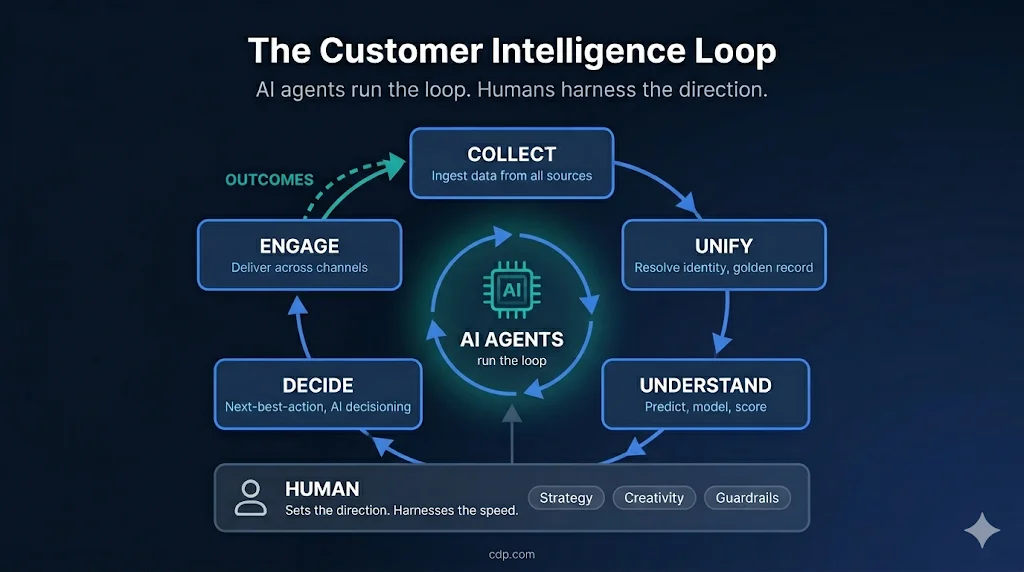
Cada etapa corresponde a capacidades específicas da plataforma:
| Etapa | O que acontece | Capacidade da plataforma |
|---|---|---|
| COLETAR | Ingerir dados de qualquer fonte: comportamento, transação, CRM, atendimento, IoT | Mais de 170 conectores prontos, ingestão por streaming e em lote |
| UNIFICAR | Resolver identidades entre dispositivos, canais e contas em perfis unificados | Resolução de identidade com aprendizado de máquina, correspondência determinística e probabilística |
| ENTENDER | Analisar o comportamento do cliente, prever intenção e calcular propensão | Análise preditiva, modelagem de valor de vida, previsão de churn |
| DECIDIR | Determinar a próxima melhor ação para cada cliente | Motor de decisão com IA, arbitragem de ofertas em tempo real |
| ENGAJAR | Executar experiências personalizadas em todos os canais | Mensageria multicanal nativa, ativação de dados para sistemas externos |
Os resultados de engajamento (abertura de e-mail, conversão de compra, interação com o atendimento) voltam para a etapa COLETAR e fecham o ciclo. No modelo agêntico, os agentes de IA percorrem esse ciclo continuamente, em vez de esperar por campanhas iniciadas por pessoas. Para operações que executam campanhas semanais em lote, sem exigência de personalização em tempo real ou dentro da sessão, o ciclo contínuo pode não ser necessário: arquiteturas composable que rodam o ciclo em cadência diária ou semanal entregam valor suficiente com menos complexidade.
Governança e segurança
A governança de dados corporativa é requisito básico para qualquer plataforma que trate dados pessoais em escala. Os recursos de governança da Treasure AI incluem:
- Certificações de conformidade: SOC 2 Tipo II, GDPR, CCPA e elegibilidade para HIPAA
- Infraestrutura: funciona na AWS, com integração ao Bedrock para as cargas de trabalho de IA
- Trilha de auditoria: registro à prova de adulteração de todo acesso a dados, toda ação de agente e todo evento de ativação
- Gestão de consentimento: aplicação centralizada do consentimento em todos os canais de ativação
- Residência de dados: opções de armazenamento regional para organizações sujeitas a exigências de localização de dados
- Instruções para agentes em toda a organização: administradores podem definir até 16.384 caracteres de instruções permanentes, acrescentadas ao prompt de sistema de todos os agentes do AI Studio na organização em novas conversas. As instruções orientam o comportamento; o acesso aos dados continua sujeito aos controles técnicos acima
- Política de dados para IA: os dados de cliente nunca são usados para treinar modelos de IA
Para a lista completa de certificações e a documentação de segurança, veja o Treasure AI Trust Center.
Uma operação brasileira precisa ler essa lista com um cuidado a mais: a LGPD (Lei Geral de Proteção de Dados) não aparece nela, e as certificações citadas cobrem o par americano-europeu. Peça ao fornecedor o mapeamento das bases legais da LGPD para cada finalidade de tratamento, o fluxo de atendimento aos direitos do titular dentro dos prazos da lei e a região de armazenamento aplicável ao seu contrato. A ANPD, autoridade nacional de proteção de dados, fiscaliza esse tratamento independentemente de onde o fornecedor tem sede.
A trilha de auditoria à prova de adulteração importa em especial nos setores regulados: organizações de serviços financeiros e de saúde precisam de registro comprovável de quem (ou de qual agente) acessou os dados de cliente e de quais ações foram executadas.
Quem deve considerar a Treasure AI
A Treasure AI atende melhor organizações que:
- Precisam do Customer Intelligence Loop completo em uma plataforma só: ingestão de dados, resolução de identidade, decisão com IA e ativação sem integrar vários fornecedores
- Querem agentes de IA operando sobre dados de cliente unificados: não apenas painéis para pessoas, mas uma arquitetura centrada em agentes, em que a IA executa continuamente
- Exigem governança de nível corporativo: conformidade com SOC 2, GDPR, CCPA e HIPAA, com ações de agente de IA auditáveis
- Operam em vários canais: e-mail, SMS, push, mensagem no aplicativo, LINE, personalização web e ativação de mídia paga
- Já investiram em data warehouse: o Composable Audience Studio monta e ativa públicos diretamente sobre tabelas de Snowflake, Databricks e BigQuery, e os agentes do AI Studio consultam dados de Snowflake e Databricks durante uma conversa
- Atendem mercados da Ásia-Pacífico: integração nativa com LINE e suporte a residência regional de dados
Organizações para as quais outras arquiteturas podem servir melhor:
- Times que só precisam de reverse ETL: operações com data warehouse maduro, lógica de segmentação já escrita em SQL e nenhuma necessidade de resolução de identidade, de decisão com IA ou de mensageria nativa costumam se resolver com uma ferramenta isolada de reverse ETL. A arquitetura híbrida da Treasure AI se conecta aos mesmos warehouses, mas a plataforma inteira pode ter mais capacidade do que a operação precisa
- Organizações comprometidas por inteiro com uma única suíte (só Adobe ou só Salesforce) podem encontrar integração mais estreita dentro daquele ecossistema, apesar das contrapartidas do suite tax. Ainda assim, quem usa Salesforce e Adobe ao mesmo tempo, ou mistura produtos de suíte com ferramentas best-of-breed, costuma unificar melhor os dados entre suítes com uma plataforma neutra como a Treasure AI do que com a CDP de qualquer uma das duas
- Pequenas empresas com necessidade simples de dados (menos de 100 mil perfis, um ou dois canais) podem não precisar das capacidades corporativas da plataforma
FAQ
O que aconteceu com a Treasure Data?
A Treasure Data mudou de marca para Treasure AI em 20 de abril de 2026. O domínio da Treasure Data passou de treasuredata.com para treasure.ai, e o produto evoluiu de plataforma de dados do cliente para plataforma de experiência agêntica. Todas as integrações, APIs e SDKs de clientes existentes continuam retrocompatíveis: a mudança de marca reflete uma evolução de produto, não uma quebra de compatibilidade.
Qual a diferença entre a Treasure AI e as outras CDPs?
A Treasure AI reúne CDP, mensageria multicanal e agentes de IA em uma plataforma só, que roda o Customer Intelligence Loop continuamente. A maioria das CDPs cuida da unificação de dados e da segmentação, mas exige ferramentas separadas para mensageria e decisão com IA, tipicamente de 4 a 5 fornecedores em um stack composable (warehouse, reverse ETL, ESP e camada de IA). A Treasure AI mantém as cinco etapas do ciclo dentro de uma plataforma só, o que elimina a duplicação de dados pessoais e a latência entre fornecedores que o reverse ETL introduz. Para o comparativo detalhado, veja o comparativo de fornecedores de CDP.
A Treasure AI é a CDP certa para a minha organização?
A Treasure AI é a CDP certa para empresas globais e multimarca, B2C e B2B, com dados em grande escala e necessidade de cobertura na Ásia-Pacífico, e é a escolha errada para times pequenos ou que dependem de autonomia da equipe de marketing. Escolha a plataforma pela unificação de dados em escala massiva, pela IA preditiva e agêntica nativa e pelos conectores nativos da Ásia-Pacífico (LINE, Yahoo! JAPAN Ads). Descarte a plataforma se você precisa de autonomia da equipe de marketing ou tem orçamento de pequena e média empresa.
A Treasure AI é uma CDP ou outra coisa?
A Treasure AI inclui uma CDP completa (ingestão de dados, resolução de identidade, segmentação e ativação) e a estende com mensageria nativa e capacidades de agente de IA. O rótulo “plataforma de experiência agêntica” reflete o acréscimo da decisão e da execução com IA sobre a base de CDP. Quem avalia a Treasure AI em relação a outras CDPs deve comparar o escopo completo da plataforma, não apenas a camada de unificação de dados. Veja o que é uma CDP agêntica para acompanhar como essa categoria evolui.
A Treasure AI é uma CDP em tempo real?
Sim. A camada Real-Time 2.0 da Treasure AI processa eventos por streaming em milissegundos, faz a costura de identidade à medida que os eventos chegam e oferece um SLA de ≤100 ms no percentil 95 (p95) para até 20 atributos na Personalization API, mediante contratação do Enterprise Support. As ativações por gatilho são entregues em até 3 minutos de ponta a ponta. Em paralelo, os processos em lote calculam scores preditivos e atualizam as relações de identidade; a camada em tempo real consulta o perfil em lote ao processar novos eventos.
A Treasure AI funciona com Snowflake, Databricks e BigQuery?
Sim. O Composable Audience Studio da Treasure AI monta e ativa públicos sobre tabelas do Snowflake, do Databricks e do BigQuery sem copiar as tabelas de origem para a Treasure AI. O processamento das consultas é cobrado no warehouse do cliente. A equipe de dados do cliente mantém o esquema das tabelas. Os agentes do AI Studio também consultam Snowflake e Databricks em conversas, por meio de conexões OAuth autorizadas por cada usuário.
Veja como os analistas avaliam os fornecedores de CDP → IDC MarketScape | Forrester Wave
Este artigo também está disponível em: What Is Treasure AI (Formerly Treasure Data)? · Treasure AI(旧Treasure Data)とは?特徴と沿革 · ¿Qué es Treasure AI (antes Treasure Data)? · Treasure Data (Treasure AI) : la CDP, ses limites · Treasure AI: CDP-Profil für Deutschland