Treasure AI(旧Treasure Data)とは、あらゆるソースから顧客データを統合し、チャネルをまたいで名寄せを行い、パーソナライズ、メッセージング、意思決定をAIエージェントが自律的に実行するAgentic Experience Platform(AIエージェントが顧客体験の実行までを担うプラットフォーム)である。人間は創造性と戦略的な判断によって、その方向を導く。 このプラットフォームは、初期のCDP(カスタマーデータプラットフォーム)の一つから出発し、CDP、オムニチャネルメッセージング、AIを一体化してCustomer Intelligence Loop(顧客データの収集・統合・活用を継続的に回す仕組み)を回し続けるシステムへと発展してきた。
開示: cdp.comはTreasure Data(現Treasure AI)が運営している。本稿は他のベンダープロファイルと同じ編集基準に沿って書いているが、読者はこの関係を踏まえたうえで読んでほしい。すべてのCDPベンダーの横並び比較はCDP Vendor Comparison Guideを参照してほしい。
Treasure AIの概要
| 項目 | Treasure AI |
|---|---|
| 向いている企業 | 大規模なデータ環境を持つグローバルな複数ブランド企業(B2C・B2B双方)で、特にAPACカバレッジと複数リージョンのデータレジデンシーが必要な場合 |
| 企業規模 | ミッドマーケットとエンタープライズ。規模別に分類されたG2レビュー163件のうち39.9%が従業員1,000人超の組織、36.8%が51〜1,000人、23.3%が50人以下の組織からのものである |
| 料金モデル | プロファイル数課金にイベント数課金を加えた個別見積もり。Complete CDPではクエリとセグメンテーションの計算費用を別途課金しない。Composable構成のクエリは顧客のウェアハウスの計算リソースを使い、その費用は顧客側で負担する |
| 導入期間 | 初期4〜8週間。企業全体への展開は3〜6か月 |
| 主な特徴 | 本稿で扱うパッケージ型CDPの中で最も広い機能範囲。パッケージ型・コンポーザブル構成の両デプロイ、ネイティブの予測AIとエージェンティックAI、そして単一プラットフォーム内でのネイティブなメール・SMS・プッシュ通知配信。さらにAPACネイティブのコネクタ(LINE、Yahoo! JAPAN Ads)が地域への適合性を高める |
| 見送り基準 | マーケター単独で運用できる簡便さ、またはSMB向けの価格帯が必要な場合 |
上の規模別の数値は各ベンダーの顧客構成ではなく、そのベンダーをレビューした人の内訳であり(レビューは自己選択で投稿され、ベンダーがレビュー投稿キャンペーンを行うため)、分類済みのレビュー件数はページ内の別の箇所で示すG2の総レビュー件数より少ない。規模別の内訳がないベンダーでは、その行は構造上の事実にもとづく。横並びの比較と算出方法はCDPベンダー比較ガイドにある。
沿革
Treasure Dataは2011年、カリフォルニア州マウンテンビューで創業した。当初はログデータとビッグデータ分析を扱うクラウド型のデータ管理プラットフォームだった。その後、事業の焦点を顧客データへ移し、大規模なデータ取り込み、名寄せ、オーディエンスのアクティベーションを支える基盤を構築していった。これが同社のCDPになった。
主な出来事は次のとおりである。
| 年 | 出来事 |
|---|---|
| 2011 | カリフォルニア州マウンテンビューでビッグデータ管理プラットフォームとして創業 |
| 2013 | エンタープライズ向けの顧客データ管理へ事業を拡大 |
| 2018 | Arm Holdings(ソフトバンクグループ)が約6億ドルで買収し、エンタープライズ市場への展開が加速 |
| 2020 | Forrester Wave(Customer Analytics Technologies)でLeaderに選出 |
| 2022 | Forrester Wave(CDP)でStrong Performerに選出 |
| 2024 | 2024年版Forrester Wave(CDP)でLeaderに選出。データ基盤の強さとエンタープライズ規模での拡張性が評価された |
| 2026 | Treasure DataからTreasure AIへリブランドし、Agentic Experience Platformを発表 |
| 2026 | IDC MarketScape: Worldwide AI-Enabled Customer Data Platforms for B2C UsersでLeaderに選出(Doc #US53952526) |
| 2026 | 同 B2B Users部門でもLeaderに選出(Doc #US53952326)。B2CとB2Bの両方でLeaderとなった点はSalesforceと共通する |
2026年時点で、Treasure AIは小売、金融サービス、ヘルスケア、自動車、消費財、メディアなど、400社を超えるエンタープライズ企業に導入されている。プラットフォームが扱う統合プロファイルは、全世界で数十億件に達する。
Treasure DataからTreasure AIへのリブランド
2026年4月20日、Treasure Dataは正式にTreasure AIとなった。ドメインはtreasuredata.comからtreasure.aiへ変わり、製品カテゴリーも「Customer Data Platform」から「Agentic Experience Platform」へ移っている。
このリブランドは、プラットフォームが担う役割の構造的な変化を反映している。Treasure Dataは、人間が統合された顧客データにアクセスしてマーケティング上の判断を下すためのシステムだった。Treasure AIは、AIエージェントが統合された顧客データにアクセスし、判断から実行までを自律的に行うためのシステムとして設計されている。人間が担うのは戦略、創造性、ガードレールである。
移行を特徴づける変化は3つある。
-
データのプラットフォームから体験のプラットフォームへ。 従来のCDPが担っていたのは、データ取り込み、統合、オーディエンスのアクティベーションだった。新しいプラットフォームはここに、オムニチャネルメッセージング(メール、SMS、モバイルプッシュ通知、アプリ内メッセージ、LINE)、AI意思決定、リアルタイムのパーソナライズを加えた。Customer Intelligence Loopの段階ごとに別々のベンダーをつなぎ合わせる必要がなくなる。
-
人間中心からエージェント中心のアーキテクチャへ。 主たるインターフェースは、ダッシュボードとクエリビルダーから、MCP(Model Context Protocol)、CLI、API、あらかじめ用意されたエージェントスキルを通じて動くAIエージェントへ移りつつある。戦略の方向づけは人間が続けるが、規模を伴う実行はAIエージェントが担う。
-
バッチ処理のサイクルから継続的なループへ。 CDPはセグメンテーションを日次や週次のバッチで回していた。Agentic Experience Platformは、収集・統合・理解・意思決定・エンゲージメントの5段階を数分単位で回し、エンゲージメントの結果が次のサイクルへ戻る。
既存のAPI、SDK、ワークフローは後方互換性を保っている。リブランドは製品の進化であり、既存の連携を壊す移行ではない。
プラットフォームのアーキテクチャ
Treasure AIは、コントロールプレーンとデータプレーンを分離したハイブリッド構成を採る。
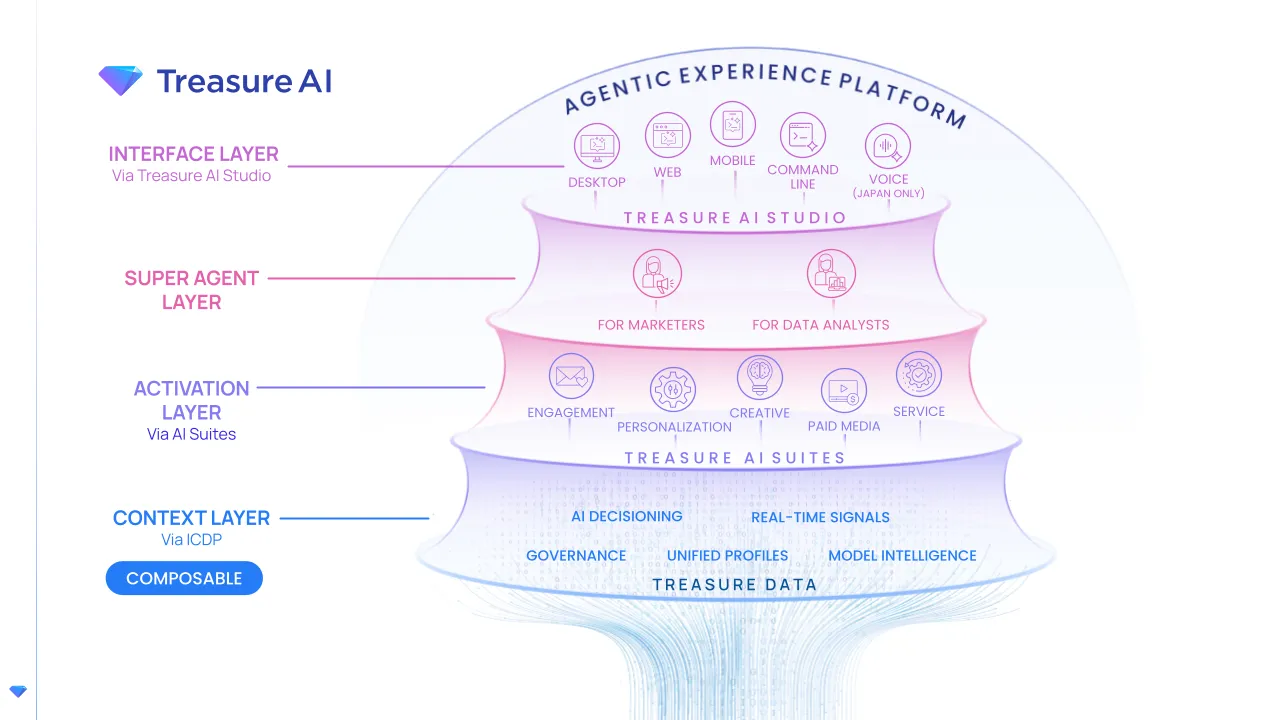
Treasure AIのAgentic Experience Platformのアーキテクチャ。コンテキストレイヤー(iCDP)はコンポーザブルであり、その上にアクティベーション、AIエージェント、複数のインターフェースが載る。
-
コントロールプレーン(Treasure AI側):名寄せ、オーディエンスセグメンテーション、AI意思決定、メッセージングのオーケストレーション、AIエージェントの実行環境。Customer Intelligence Loopが回るマネージドなレイヤーである。
-
データプレーン(顧客側の基盤):顧客データは自社のデータウェアハウスに置いたままでよい。Snowflake、Databricks、BigQueryが対象になる。Treasure AIはデータを独自ストレージへ移さず、これらのウェアハウスのテーブルをその場で照会する。逆方向には、Treasure AIが管理するテーブルを読み取り専用のApache Iceberg形式で公開し、同じウェアハウスからコピーを増やさずに照会できる。
このハイブリッドなデプロイモデルが応えているのは、CDP市場で長らく両立の難しかった2つの要求である。コンポーザブルCDPはデータをウェアハウスに置いたまま扱えるが、AIのループをAPIの応答速度でリアルタイムに回すことはできない。パッケージ型CDPは高速に動くものの、すべてのデータを独自ストレージへ複製する必要がある。Treasure AIは、ウェアハウス上にデータを残したまま、低レイテンシーでのプロファイル参照とリアルタイムのアクティベーションに向けて設計したマネージドなコントロールプレーンを組み合わせ、この両立を狙っている。
主要プロダクト
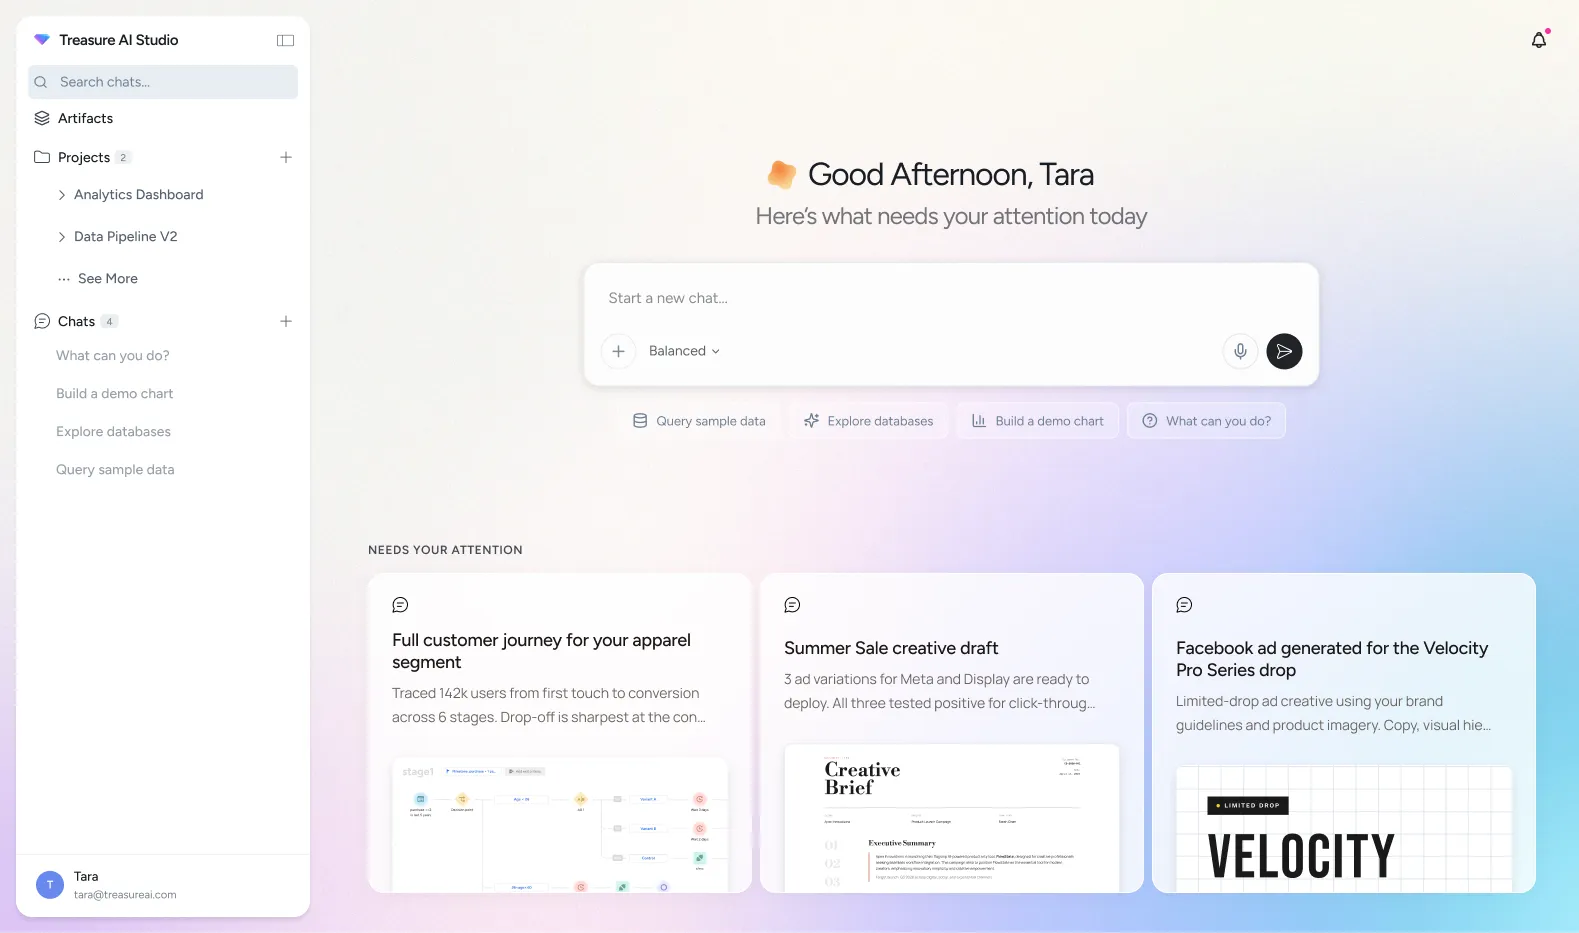
Treasure AI Studio
Treasure AI Studioは、このプラットフォームの主たるインターフェースであり、複数の環境で提供されている。
- Web:マーケター、アナリスト、データチームが使うブラウザ上のワークスペース
- デスクトップ:macOSとWindows向けのネイティブアプリケーション
- モバイル:外出先での状況確認と承認に使うiOSおよびAndroidアプリ
- CLI(Treasure Code):エンジニアとデータチームがプラットフォームをプログラムから操作するためのコマンドラインインターフェース。Treasure CodeはClaude Codeを基盤としており、顧客データへのアクセス、スキーマの確認、パイプラインの操作をターミナルから行える
- 音声(Treasure AI Voice):ハンズフリーでの問い合わせとメモの記録に対応するAI音声インターフェース
Studioは、顧客データへの自然言語でのアクセス、セグメントの作成、キャンペーン管理、分析を提供する。SQLを書かず、エンジニアの手も借りずに、技術者以外の担当者が顧客データを問い合わせ、そのまま行動へ移せるように設計されている。
Studioのエージェントは、Treasure AIの内部にあるデータだけを扱うわけではない。
2026年6月からのAI Studio Connectionsにより、チャット中にSnowflake(6月25日追加)やDatabricks(6月17日追加)のデータを探索・可視化できる。
7月14日にはTreasure Data CDPにも同じ接続方式が加わり、エージェントがチャットからCDPのクエリ、ワークフロー、オーディエンスセグメントを操作できるようになった。
管理者が組織ごとにコネクタを一度登録したうえで、利用者が各自の接続をOAuthで認可する。
エージェントが受け取るのは仮のトークンだけで、実際の認証情報はネットワーク境界で置き換えられる(2026年6月のリリースノート)。
参照できるデータは認可されたウェアハウス側のロールの権限に従う。
ただしAI StudioのSnowflakeコネクタはSnowflakeのPUBLICロールで認可されるため、エージェントに許可したテーブルはSnowflakeのほかの利用者全員にも見える。
権限の付与範囲をその前提で絞る必要がある。
後述するComposable Audience Studioは、これとは別に設定したSnowflakeの認証情報を使う。
Studioでは、個別のチャットではなく作業フォルダーに業務の文脈を蓄積する。 各フォルダーの指示ファイルをAIがチャット開始時に読み、作業の進行に応じて更新できるため、テーブル名、運用上の取り決め、目的を毎回伝え直す必要がない(チャットをまたぐ記憶の説明)。 2026年9月17日からは、作業フォルダーをアカウント内で共有できる。 メンバーは共通の指示、参照ファイル、スキル、保存済みアクションを読み、それぞれのAIで作業する。 たとえば週次のキャンペーンレポートに使うテーブル、対象セグメント、出力形式を担当者がフォルダーに記録すれば、同僚のエージェントもその手順を引き継げる。 各人に書き込み権限があれば、エージェントの更新も次のチャットに残り、チームの作業知識を個人のチャット履歴とは別の場所で共有できる。
ただし、フォルダーの共有は会話や個人ファイルの共有を意味しない。
チャットと各メンバーのmy/ディレクトリは非公開のままである。
共有側への書き込み範囲は、書き込み不可、指定された最上位フォルダーのみ、全域という作業モードで制御され、指示文ではなくファイルシステムの権限として適用される。
共有フォルダーを管理するのはそのフォルダーの管理者であり、アカウント管理者でもフォルダー内の作業モードを割り当てられていなければ中身を読めない(アクセス制御)。
繰り返す業務は、フォルダーに保存して定期実行できる。 2026年8月13日追加のWork Folder Actionsは、同じ手順を必要なときに再実行できる形で保存する。 8月25日追加のAction Schedulesを使えば、日次、平日、週次、月次、またはカスタムのcron設定で、誰も実行ボタンを押さずにアクションを起動できる(2026年8月のリリースノート)。 これは定時実行であり、顧客の行動を契機に即座に動く仕組みではない。 後者にはリアルタイムの処理層が必要になる。
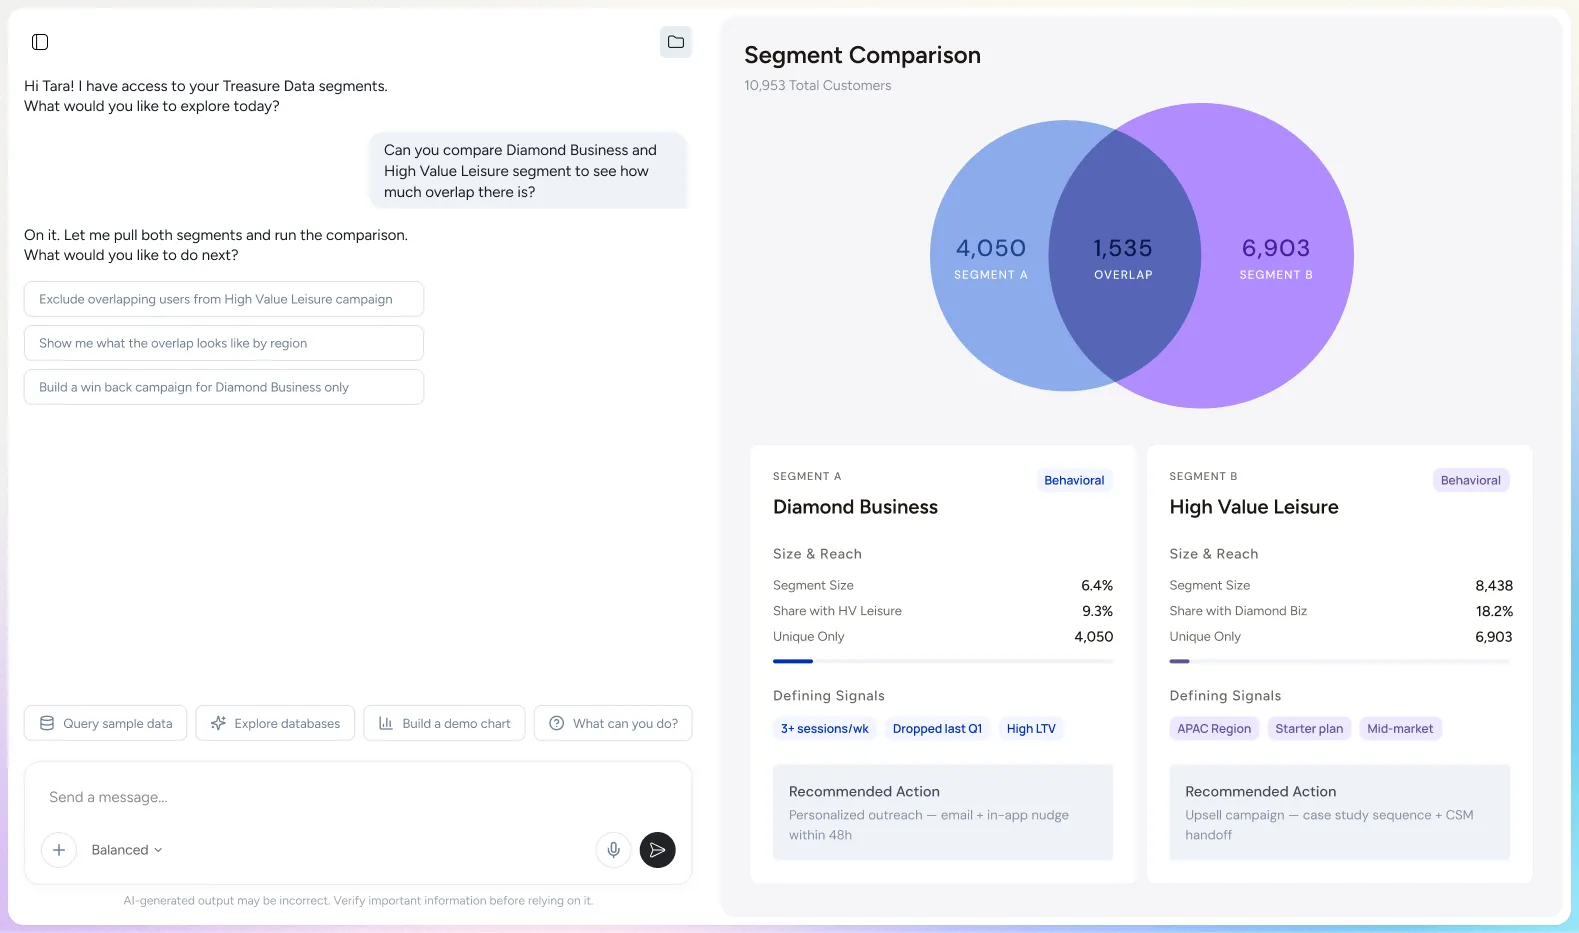
Treasure AI Studioでのセグメント比較。自然言語の問い合わせからオーディエンスの重なりを分析し、次に取るべきアクションまで提示する。手作業のSQLやBIの手順を経ずに、AIエージェントが示唆を引き出す例である。
AI Super Agent
AI Super Agentは、Customer Intelligence Loopの中の特定の業務を自動化する、領域特化のAIエージェントである。
-
マーケター向けのAI Super Agent:オーディエンスの発見、キャンペーンの作成、ネクストベストアクションの提案、チャネルを横断したアクティベーションを担う。ウィンバックのセグメントを何時間もかけて手作業で組む代わりに、マーケターは「第1四半期に購入したが、直近60日間反応がない顧客を見つけてほしい」と目的を言葉で伝える。エージェントがセグメントを構築し、チャネルを選び、施策を実行する。
-
データアナリスト向けのAI Super Agent:データの探索、示唆の抽出、レポート作成を自動化する。アナリストが日常の言葉で質問すると、裏付けとなるデータの可視化を伴う構造化された回答が返る。早期アクセスの段階では、ある金融サービス企業のチームが、定型的な顧客関連の問い合わせについてレポート作成の所要時間を3日から60秒へ短縮したと報告している。
これらのエージェントは、統合された顧客データ基盤の上に構築されている。サイロ化したツールに散らばった断片的なデータではなく、名寄せ済みの完全な顧客プロファイルを扱う。
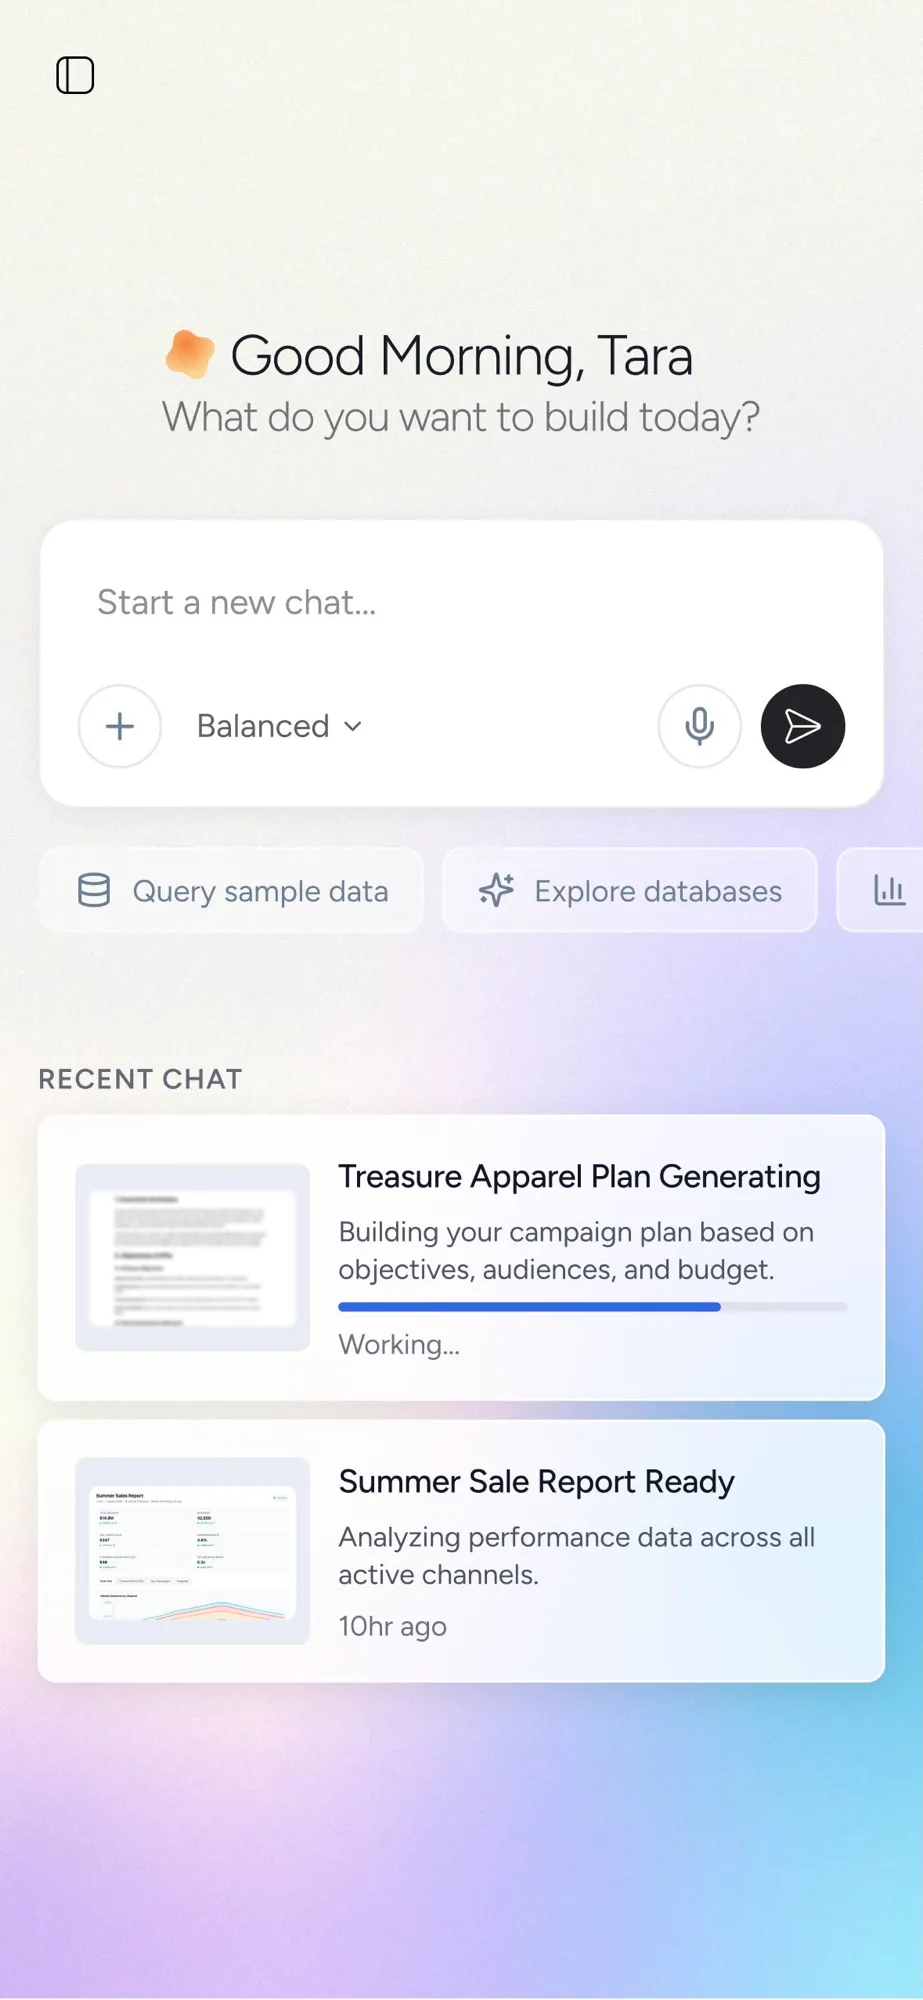
Treasure AI Studio(モバイル)。iOSとAndroidでも同じ対話型のインターフェースを使い、外出先からキャンペーンの状況確認と承認を行える。
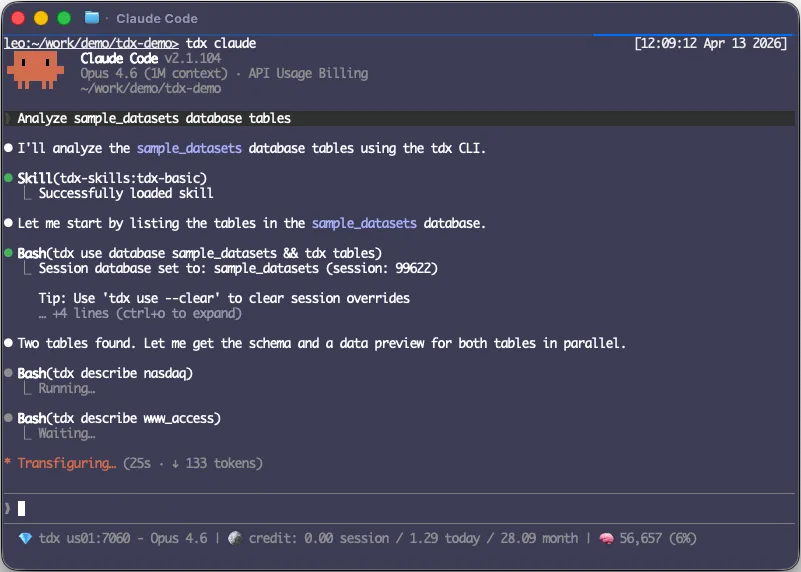
Treasure Code(CLI)。エンジニアはClaude Codeを基盤としたターミナル上のインターフェースからTreasure AIを操作し、スキーマの確認、クエリの実行、データパイプラインの管理をコマンドラインのまま行える。
オムニチャネルメッセージング
プラットフォームには、次のチャネルへのメッセージング機能が組み込みで備わっている。
- メール:AIによる配信時刻の最適化を伴うパーソナライズ済みのコンテンツ(Email Marketing)
- SMS:取引に伴う通知とプロモーションのメッセージ。2026年9月からは受信者ごとの短縮リンクと組み込みのクリック計測にも対応する(SMS Marketing)
- モバイルプッシュ通知:iOSおよびAndroid向けのプッシュ通知(Mobile App Marketing)
- アプリ内メッセージ:モバイルアプリの中で文脈に応じて出すメッセージ
- LINE:LINEへのネイティブ連携。2026年8月からはLINE公式アカウントのテキスト、イメージマップ、Flexメッセージを、メールやプッシュ通知と並ぶ常時稼働型のキャンペーンで配信できる。日本国内では主要な顧客接点であり、連携の有無が運用上の差になる
メッセージングを別の顧客エンゲージメントプラットフォームに頼らずプラットフォーム内に持つことで、開封、クリック、コンバージョンといったエンゲージメントの結果が、ベンダーをまたぐレイテンシーを挟まずにCustomer Intelligence Loopへ戻る。
コンテキストレイヤーとしてのTreasure Data(CDP)
プラットフォーム全体の土台にあるのがTreasure Dataであり、コンテキストレイヤーとして機能するインテリジェントなCDPである。ここで顧客データが取り込まれ、名寄せが行われ、統合プロファイルが構築され、ガバナンスのポリシーが適用される。Studio、AI Super Agent、メッセージングといった上位のプロダクトは、すべてこのレイヤーに対して読み書きする。
コンテキストレイヤーの主な機能は次のとおりである。
- データ取り込み:CRM(顧客関係管理システム)、EC、Web分析、POS、サポート、IoTなどのソースから、バッチとストリーミングの両方で取り込む170以上の標準コネクタ
- 名寄せ:デバイス、チャネル、アカウントをまたいで顧客を特定する、機械学習による確定的マッチングと確率的マッチング
- 統合プロファイル:行動データ、取引データ、属性データを一つのレコードへ集約する、永続的なCustomer 360プロファイル
- AI意思決定とモデル:予測分析、プロペンシティスコアリング、リアルタイムのシグナル処理。ループの理解と意思決定の段階を支える
- データガバナンス:フィールド単位のアクセス制御、同意の適用、下流のアクティベーション全体にわたるコンプライアンスの自動化
これは、アーキテクチャ図で「Composable」と示されているレイヤーにあたる。組織はハイブリッドなデプロイモデルを通じて既存のデータウェアハウス(Snowflake、Databricks、BigQuery)へ接続し、データをウェアハウス上に残したまま、名寄せ、AI、ガバナンスをこのレイヤーに任せられる。
コンテキストレイヤーには2つの動作モードがある。Complete CDPは、データの取り込みと保管までをプラットフォーム内で完結させるフルマネージドの構成であり、既存のウェアハウスがなくても標準コネクタ、名寄せ、セグメンテーション、アクティベーションを利用できる。 Composable CDP(Composable Audience Studio)はウェアハウスを起点とする構成で、Treasure AIがSnowflake、BigQuery、Databricksへ連携クエリを送り、各ウェアハウスの計算リソースで実行した結果だけを受け取る。 リバースETLで別のストレージへ同期する方式ではない。 マーケターは画面上でオーディエンスを構築でき、元のテーブルはウェアハウスに残る。 クエリの結果はTreasure AIへ返り、顧客データはオーディエンスをアクティベーションした時点で配信先へ送られる。 同じプラットフォームにはマネージドな名寄せ、AI意思決定、ネイティブなメッセージングもある。 コンポーザブル専業製品との比較では、各製品がそれらを標準で備えるか、連携で実現するか、選ぶ構成モードでも使えるかを確かめるとよい。 構成の比較にはコンポーザブルCDPとCDPベンダー比較ガイドを参照してほしい。
Snowflake、Databricks、BigQueryでのComposable Audience Studio
2026年、Composable Audience StudioはSnowflakeとDatabricksに4月27日、BigQueryに5月11日から対応した(4月、5月のリリースノート)。 その後は、監査ログ、セグメント単位の権限制御、ウェアハウス上の費用の把握、設定のコード管理など、運用面の機能が加わっている。
| 日付(2026年) | 公開された機能 | データチームへの意味 |
|---|---|---|
| 4月27日 | SnowflakeとDatabricks向けComposable Audience Studio | Treasure AIへデータをコピーせず、ウェアハウスのテーブルでセグメント作成、予測スコアリング、アクティベーションを行う |
| 5月11日 | BigQuery向けComposable Audience Studio | BigQueryのテーブルでセグメント作成とアクティベーションを行う |
| 6月10日 | Premium監査ログのイベント | 権限による拒否も含め、マネージド型Audience Studioと同等の監査ログを記録する |
| 6月30日 | ポリシーにもとづく権限 | コンポーザブル構成の親セグメントとセグメントフォルダーごとに、フルアクセス、限定アクセス、アクセス不可を指定できる |
| 7月24日 | tdx cas pushによるYAMLでの作成・更新 | オーディエンス、属性、行動、セグメント、アクティベーションをコードで管理し、変更の適用前にプレビューできる |
| 8月16日 | Open Catalog Access | 逆方向の連携。Complete CDPのテーブルをApache Iceberg形式で読み取り専用として公開し、ウェアハウスからその場で照会する。SnowflakeとDatabricksは一般提供、BigQueryは試験提供で、利用には申請が必要 |
| 9月2日 | Snowflakeのクエリタグ | セグメンテーション、アクティベーション、プロファイル参照などのクエリにJSON形式のQUERY_TAGを付け、オーディエンス、セグメント、アクティベーションごとの計算費用を把握できる |
各ウェアハウスの認証方式は異なるが、データモデルは共通である。 コンポーザブル構成の親セグメントには、プロファイルごとに一意のIDを持つ1行を格納した顧客テーブルを使い、日時の列を持つ行動テーブルを一対多で結合する(Snowflakeの設定ガイド)。
| ウェアハウス | 認証 | 設定時の主な要件 |
|---|---|---|
| Snowflake | キーペア認証 | クエリ実行用ウェアハウスと、対象テーブルにSELECT権限を持つユーザーとロール |
| Databricks | OAuthを使うサービスプリンシパル | Unity Catalogの有効化と、SQLウェアハウスまたは計算クラスター |
| BigQuery | JSONキーを持つGCPサービスアカウント | サービスアカウントの作成とIAMロールの管理権限 |
コンポーザブル構成は、ウェアハウス上のテーブルを用いたオーディエンス構築という点で、専業のコンポーザブル製品と共通する。 一方、Treasure AIのこの構成ではクエリが顧客側のウェアハウスの計算リソースを使うため費用が変動し、スキーマの設計・保守と性能の調整も顧客のチームが担う(Composable CDPの文書)。 コピーを作らないのはバッチデータをオーディエンスのアクティベーションに使うまでであり、広告プラットフォームやメッセージ配信先へ送る段階では、ほかのコンポーザブル製品と同様にデータがウェアハウスの外へ出る。 保管やスキーマの運用までTreasure AIに任せたい組織にはComplete CDPがある。
Real-Time 2.0とリアルタイムプロファイル
顧客がジャケットをカートに入れて閲覧している間、現在のカートと過去の購買履歴を踏まえてオファーを出し、離脱後には別のトリガーでフォローのメッセージを送れる。 Treasure AIのReal-Time 2.0は、届いたイベントをリアルタイムとバッチの2つの経路へ同時に送る(Real-Timeの概要)。 リアルタイム側の意思決定エンジンはイベントをミリ秒単位で処理し、名寄せを進め、セッション内の回数やカート金額などのリアルタイム属性を更新する。 その時点のイベントと保存済みのバッチプロファイルも組み合わせる。 一方、バッチ側は通常数分から数時間の間隔でワークフローを動かし、イベント履歴の集計、予測スコアの算出、名寄せ関係の更新を担う。 リアルタイム側がイベントを処理するときに最新のバッチプロファイルを読むため、セッション中の判断にも過去の顧客情報が反映される。
名寄せはストリーム上でも進む。 たとえば1件目のイベントがメールアドレスとCookie ID、次のイベントが同じCookie IDとデバイスIDを持ち、それらが設定済みの結合キーに一致すれば、到着に合わせて匿名IDと既知のIDを一つのプロファイルに結び付ける(リアルタイムのID結合)。 過去のプロファイルについてはバッチ層が正本である。
Treasure AIが公表するリアルタイム層の処理条件は次のとおりである(性能上の制約)。
| 項目 | 公表値 |
|---|---|
| Personalization APIの応答 | 最大20属性の参照でp95が100ミリ秒以下。SLAにはEnterprise Supportの契約が必要 |
| トリガーによるアクティベーション | 評価、IDの結合、配信を含め、最長3分 |
| ストリーミング取り込み | 顧客ごとの標準値は毎秒2,000イベント。プラットフォーム全体では世界規模で毎秒100,000イベント以上まで拡張 |
| 意思決定処理 | 顧客ごとに毎秒8,000イベント |
| IDの上限 | 結合キーは最大100、1プロファイルあたりのIDは最大200。超えると古いIDから除外 |
| リアルタイム属性 | 1プロファイルあたり最大200属性、各属性500バイト |
2026年7月17日追加のLookup Catalogは、処理時にプロファイルの属性を外部の参照テーブルと結合し、商品単位の判断、クーポンのリマインド、期間限定セールの表示などに使える。 9月14日追加のリアルタイム名寄せログテーブルには、結合を拒否された識別子の値、200件の上限により除外されたID、プロファイル統合時に取り込まれたIDが記録される。 データチームはそこから名寄せの経緯を確認できる。
この2つの時間指標は用途が異なる。 サイト内でのパーソナライズにはPersonalization APIの参照時間が効き、最大20属性、Enterprise Supportの契約という条件下でp95が100ミリ秒以下になる。 離脱後のフォローはトリガーによるアクティベーションの経路を通り、Treasure AIが示す上限は3分である。 親セグメントが100以上ある導入では先に概念実証で性能を確認するとよい。 週次のキャンペーンや月次レポートだけが用途なら、リアルタイムの経路は不要な場合もある。
早期アクセスでの成果
2026年の早期アクセス期間中に、Treasure AIは2件の導入成果を公表している。
- 大手小売:AI Super Agentを使い、セグメント作成から施策実行までの所要時間を5日間から8時間へ短縮した。手作業の分析では見つからなかった34万件規模の高関心セグメントをエージェントが発見し、コンバージョンは23%向上した。
- 金融サービス:データ分析チームが、3日かかっていたレポート作成のサイクルを、Treasure AI Studioでの60秒の自然言語による問い合わせに置き換えた。アナリストはデータの抽出ではなく、その解釈に時間を充てられるようになった。
これらはベンダー自身が公表した数値であり、早期段階の導入例である。独立したアナリストによる検証や、より広い顧客ベンチマークは、プラットフォームが早期アクセスの段階を越えるにつれて明らかになる。
Customer Intelligence Loopの回り方
Customer Intelligence Loopは、顧客データが収集からアクティベーションへ流れ、エンゲージメントの結果が次の判断へ戻るまでを5段階で表した継続的なサイクルである。多くのマーケティングスタックでは、このループが手順ごとに分断されて回っている。ウェアハウスがデータを集め、別のツールが名寄せを行い、さらに別のツールがセグメントを作り、また別のツールがメッセージを送る。受け渡しのたびにレイテンシーが加わり、文脈が失われる。
Treasure AIは、その隙間をなくす原則としてこのループを据えている。5段階すべてが単一のプラットフォームの中で実行され、人間がバッチ処理を起動するのを待たずに、AIエージェントがループを回し続ける。
収集 → 統合 → 理解 → 意思決定 → エンゲージメント →(収集へ戻る)
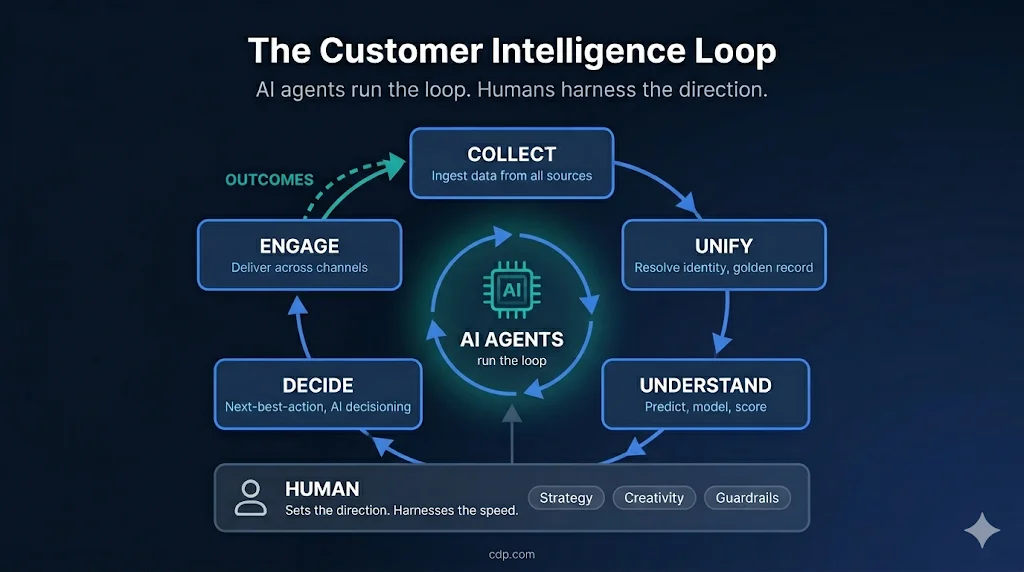
各段階は、プラットフォームの具体的な機能に対応している。
| 段階 | 起きること | 対応する機能 |
|---|---|---|
| 収集 | 行動、取引、CRM、サポート、IoTなど、あらゆるソースからデータを取り込む | 170以上の標準コネクタ、ストリーミングとバッチの取り込み |
| 統合 | デバイス、チャネル、アカウントをまたいで同一人物を突き止め、統合プロファイルにまとめる | 機械学習による名寄せ、確定的マッチングと確率的マッチング |
| 理解 | 顧客の行動を分析し、意図を予測し、見込みを数値化する | 予測分析、顧客生涯価値(LTV)のモデリング、解約予測 |
| 意思決定 | 顧客ごとに次に取るべき最適なアクションを決める | AI意思決定エンジン、リアルタイムでのオファーの出し分け |
| エンゲージメント | チャネルを横断してパーソナライズされた体験を届ける | 組み込みのオムニチャネルメッセージング、外部システムへのデータアクティベーション |
メールの開封、購買のコンバージョン、サポートでのやり取りといった結果は収集の段階へ戻り、ループが閉じる。エージェント中心の構成では、人間がキャンペーンのサイクルを起動するのを待たず、AIエージェントがこのループを回し続ける。
ただし、週次のバッチでキャンペーンを回していて、リアルタイムやセッション中のパーソナライズを必要としない組織であれば、継続的なループは必ずしも要らない。日次や週次でループを回すコンポーザブル構成でも、より簡素な仕組みで十分な価値を出せる。
ガバナンスとセキュリティ
大量のPIIを扱うプラットフォームにとって、エンタープライズグレードのデータガバナンスは前提条件である。Treasure AIのガバナンス機能には次のものが含まれる。
- コンプライアンス認証:SOC 2 Type II、GDPR、CCPAに準拠し、HIPAA対象のワークロードにも対応
- インフラ:AWS上で稼働し、AIのワークロードにはBedrockを利用
- 監査ログ:データアクセス、エージェントの動作、アクティベーションの記録を改ざん検知が可能な形で保持
- 同意管理:すべてのアクティベーションチャネルにわたって同意を一元的に適用
- データの保存地域:データの国内保管などの要件に対応した、リージョンごとの保存オプション
- 組織共通のエージェント指示:管理者は最大16,384文字の常設の指示を設定でき、新しいチャットで組織内の全AI Studioエージェントのシステムプロンプトに追加される。指示はエージェントの振る舞いを導くものであり、データへのアクセス権は上記の権限制御で定まる
- AIとデータの扱い:顧客データをAIモデルの学習には使わない
認証とセキュリティ文書の一覧はTreasure AI Trust Centerにまとまっている。
改ざん検知が可能な監査ログは、規制の厳しい業界でとりわけ意味を持つ。金融サービスやヘルスケアの組織は、誰が(あるいはどのエージェントが)顧客データにアクセスし、どの操作を行ったかを証明できる記録を求められる。
Treasure AIが向いている組織
Treasure AIが適しているのは、次のような組織である。
- Customer Intelligence Loop全体を一つのプラットフォームで回したい:データ取り込み、名寄せ、AI意思決定、アクティベーションを、複数ベンダーの継ぎ足しなしに揃えたい場合
- AIエージェントに統合された顧客データを扱わせたい:人間向けのダッシュボードにとどまらず、AIが継続的に実行を担う構成を求める場合
- エンタープライズグレードのガバナンスが必要:SOC 2、GDPR、CCPA、HIPAAへの準拠と、AIエージェントの動作の監査可能性が要件になる場合
- 複数チャネルを運用している:メール、SMS、プッシュ通知、アプリ内メッセージ、LINE、Webのパーソナライズ、広告のアクティベーションを横断する場合
- 既存のデータウェアハウス投資がある:Composable Audience StudioでSnowflake、Databricks、BigQueryのテーブルをその場で使ってオーディエンスを構築・配信できる。AI Studioのエージェントからも、SnowflakeとDatabricksをチャット中に照会できる
- 日本やアジア太平洋の市場を対象としている:LINEへのネイティブ連携と、リージョンごとのデータの保存地域に対応している
一方で、別のアーキテクチャの方が適する場合もある。
- リバースETLだけで足りるチーム:成熟したデータウェアハウスがあり、セグメントのロジックをSQLで持っていて、名寄せもAI意思決定もメッセージングも不要であれば、単体のリバースETLツールで十分なことが多い。Treasure AIのハイブリッド構成も同じウェアハウスへ接続できるが、必要以上の機能になりうる
- 単一のスイートに全面的に統一している組織:AdobeまたはSalesforceのどちらかに寄せている場合、スイートタックスというトレードオフはあるものの、同じエコシステム内の連携の方が緊密になることが多い。ただし、SalesforceとAdobeを併用している組織や、スイート製品と個別最適のツールを混在させている組織では、ベンダー中立のプラットフォームの方が、スイート自身のCDPよりも横断的なデータ統合に向くことが多い
- データ要件が単純な中小規模の企業:プロファイル数が10万件未満で、チャネルも1つか2つであれば、エンタープライズ向けの機能は過剰になりうる
評価の進め方そのものについては、How to Evaluate a CDP in the AI Eraも参照してほしい。
→ すべてのCDPベンダーを横並びで比較する(CDP Vendor Comparison Guide)
アナリストによる評価はForrester Wave CDPレポートで確認できる。
Related Articles
- すべての顧客接点AIエージェントにCDPが必要な理由:AIエージェントが共有メモリとしてCDPを必要とする理由
- How AI Is Redefining the CDP:エージェント中心のアーキテクチャがCDPの定義そのものをどう変えるか
- Packaged CDP vs Composable CDP:CDPの3世代のアーキテクチャと、それぞれが適する条件
FAQ
Treasure Dataはどうなったのか
Treasure Dataは2026年4月20日にTreasure AIへリブランドした。 ドメインはtreasuredata.comからtreasure.aiへ変わり、製品はCDPからAgentic Experience Platformへと発展した。既存の連携、API、SDKは後方互換性を保っており、リブランドは製品の進化であって、互換性を壊す変更ではない。
Treasure AIは他のCDPと何が違うのか
Treasure AIは、CDP、オムニチャネルメッセージング、AIエージェントを単一のプラットフォームに束ね、Customer Intelligence Loopを継続的に回す点が異なる。 多くのCDPはデータ統合とセグメンテーションを担うが、メッセージングとAI意思決定には別のツールが必要になり、コンポーザブル構成では通常4〜5のベンダーを組み合わせることになる。データウェアハウス、リバースETL、メール配信基盤(ESP)、AIレイヤーである。Treasure AIはループの5段階を一つのプラットフォームの境界内に収め、リバースETLが持ち込むPIIの複製と、ベンダーをまたぐレイテンシーをなくしている。
Treasure AIはCDPなのか、それとも別のものなのか
Treasure AIはCDPの機能(データ取り込み、名寄せ、セグメンテーション、アクティベーション)を備えたうえで、メッセージングとAIエージェントの機能を加えたものである。 「Agentic Experience Platform」という呼び方は、CDPという土台の上にAIによる意思決定と実行が載ったことを示している。Treasure AIをCDPと比較して検討する組織は、データ統合のレイヤーだけでなく、プラットフォーム全体の範囲を見る必要がある。このカテゴリーの変化についてはエージェンティックCDPを参照してほしい。
Treasure AIはリアルタイムCDPか
Treasure AIのReal-Time 2.0はストリーミングイベントをミリ秒単位で処理し、イベントの到着に合わせて名寄せを進めるリアルタイムCDPの処理層を備える。 Personalization APIには、最大20属性の参照でp95が100ミリ秒以下というSLAがあり、利用にはEnterprise Supportの契約が必要である。 トリガーによるアクティベーションは3分以内に配信される。 並行するバッチ経路では予測スコアの算出と名寄せ関係の更新を定期的に行い、リアルタイム側はイベントの処理時にそのプロファイルを読むため、顧客の過去の情報も判断に反映される。
Treasure AIはSnowflake、Databricks、BigQueryと連携できるか
Composable Audience StudioはSnowflake、Databricks、BigQueryのテーブル上でオーディエンスを構築・アクティベーションでき、そのために元のデータをTreasure AIへコピーする必要はない。 クエリは顧客のウェアハウスの計算リソースを使い、費用とスキーマの保守を顧客側で負担する。 AI Studioのエージェントからも、利用者ごとのOAuth認可を通じてSnowflakeとDatabricksをチャット中に照会できる。
アナリストによるCDPベンダーの評価を確認する → IDC MarketScape|Forrester Wave
この記事は他の言語でも読めます: What Is Treasure AI (Formerly Treasure Data)? · O que é Treasure AI (ex-Treasure Data)? · ¿Qué es Treasure AI (antes Treasure Data)? · Treasure Data (Treasure AI) : la CDP, ses limites · Treasure AI: CDP-Profil für Deutschland